Interpretasi Data
Literasi Data dan Penulisan Ilmiah
2026-09-25
Agenda
- Setelah data dianalisis, bagaimana melaporkannya?
- Menarasikan ketidakpastian dengan hedging
- Studi kasus: generalisasi tergesa-gesa dari subkelompok
- Melaporkan interval kepercayaan (confidence interval) dengan benar
- Mengenal questionable research practices (QRP)
Data Telah Dianalisis, Lalu?
Tiga jenis audiens
Setelah data dianalisis (Pertemuan 5), temuan pentingnya harus dikomunikasikan. Cara Anda mengomunikasikannya sangat bergantung pada siapa audiensnya:
- Komunitas akademik serumpun — latar belakang keilmuannya sama dengan Anda.
- Informed lay public — orang awam terdidik; mampu mencerna informasi kompleks, tapi di luar spesialisasi Anda.
- General lay public — orang awam tanpa latar belakang sains sama sekali.
Komunitas akademik serumpun
Anda perlu memperhatikan norma/kelaziman yang berlaku di komunitas Anda.
- Misalnya, seperti apa tata letak tulisan, aturan pengutipan, cara mempresentasikan dan mendiskusikan analisis yang diterima komunitas akademik Anda.
Tiap bidang punya gayanya sendiri: Kedokteran → AMA, Sosiologi → ASA, Teknik → IEEE, Psikologi → APA.
Dengan sejawat serumpun, Anda diperbolehkan (bahkan didorong) memakai istilah teknis, sehingga jargon justru menambah akurasi dalam proses komunikasi.
Untuk publik awam
- Berkomunikasi dengan publik awam butuh usaha lebih besar: Anda harus menyeimbangkan ketepatan dan keterbacaan.
- Ilmuwan yang baik berhati-hati menjelaskan hasil analisisnya dengan menghindari kesimpulan (ekstrapolasi) yang berlebihan dari data yang dianalisis.
- Bagian yang paling sulit: menarasikan ketidakpastian.
- Melebih-lebihkan hubungan antar variabel membuat klaim Anda dicurigai audiens; menyederhanakannya terlalu jauh membuat Anda melewatkan temuan penting (dan mungkin berisiko membuat Anda terlihat kurang kompeten).
Ingat: statistik pada dasarnya bicara soal probabilitas, jadi hindari diksi yang menyiratkan realitas yang serba pasti/rigid.
Menarasikan Ketidakpastian: Hedging Language
Apa itu hedging language?
Definisi
Hedging language adalah gaya bahasa yang dipakai ilmuwan untuk mengekspresikan kehati-hatian ketika mendiskusikan ketidakpastian dalam menginterpretasi data. Interpretasi harus diartikulasikan dengan tone yang hati-hati.
Kata kunci yang sering dipakai: “cenderung,” “mengindikasikan,” “kemungkinan,” “pada sampel ini,” “perlu diuji lebih lanjut.”
Contoh 1: Durasi tidur kucing vs. anjing
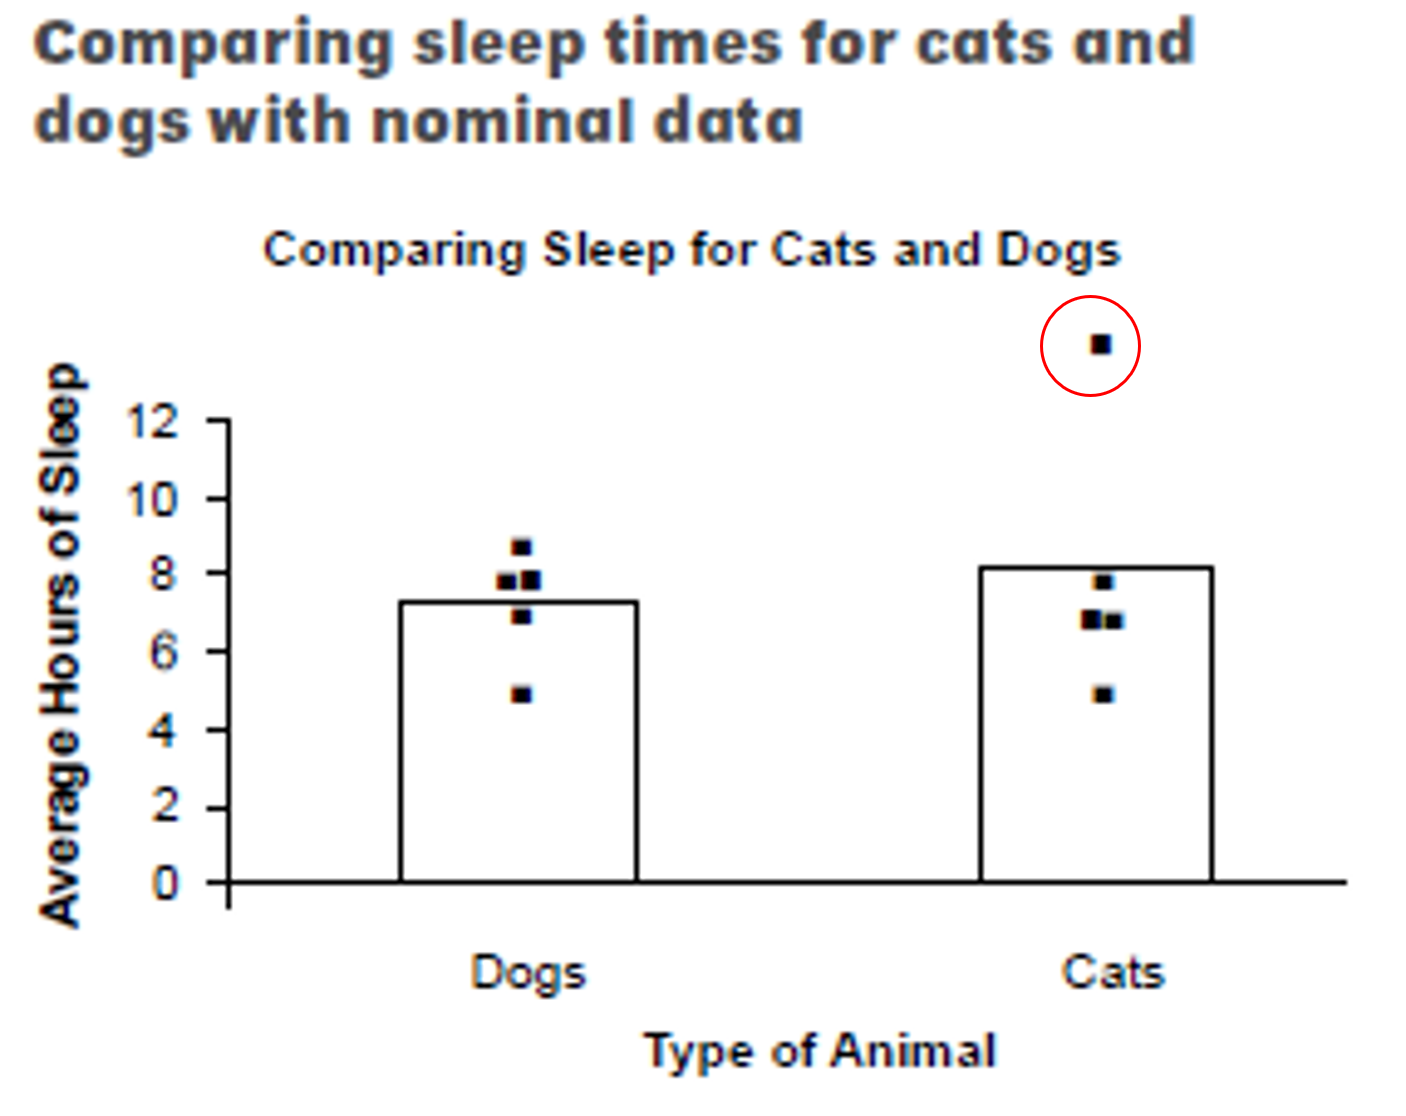
Pada grafik terlihat kucing rata-rata tidur lebih lama daripada anjing. Namun, ada satu kucing dalam sampel yang tidur jauh lebih lama daripada yang lain dan memengaruhi rerata kelompoknya. Sangat mungkin sebenarnya hanya ada sedikit perbedaan rerata durasi tidur antara kucing dan anjing, sehingga pengambilan data ulang dengan sampel yang lebih besar diperlukan untuk memastikan apakah perbedaan itu memang ada.
Kalimat ini secara eksplisit mengaitkan ketidakpastian dengan satu nilai ekstrem (outlier) dalam sampel, bukan sekadar berkata “hasilnya tidak pasti” tanpa alasan yang jelas.
Contoh 2: Panjang lengan vs. tungkai
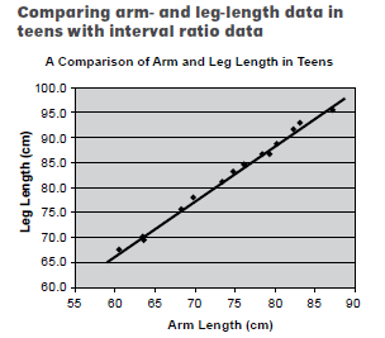
Grafik menunjukkan hubungan yang sangat kuat antara panjang lengan dan tungkai pada remaja. Semua partisipan mendekati garis tren, tanpa nilai ekstrem.
Di sini hubungannya memang kuat dan jelas. Hedging yang berlebihan justru tidak tepat. Kuncinya bukan selalu membingkai temuan dengan keragu-raguan, tapi selalu sesuaikan tingkat kepastian narasi Anda dengan kekuatan bukti yang Anda temukan.
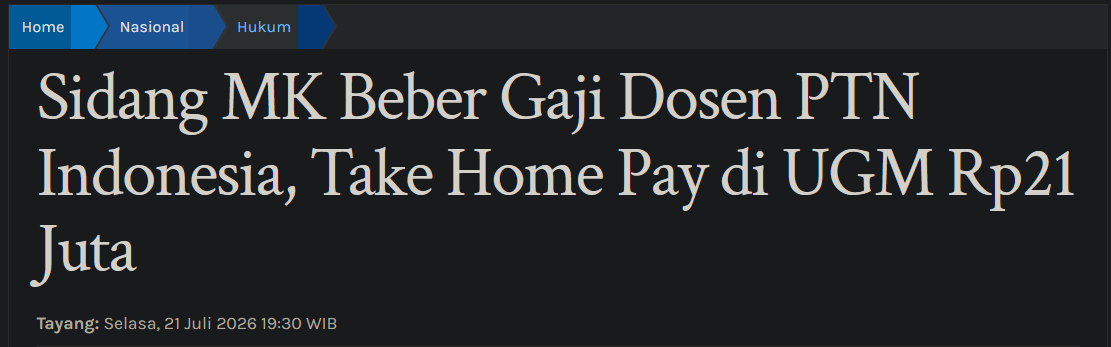
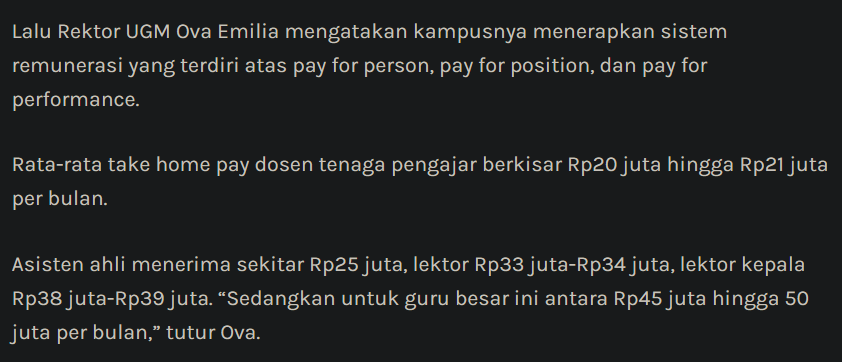
Contoh 3: Gaji Dosen UGM
Studi Kasus: Generalisasi Tergesa-Gesa dari Subkelompok ⚠️
Survei Indikator Politik
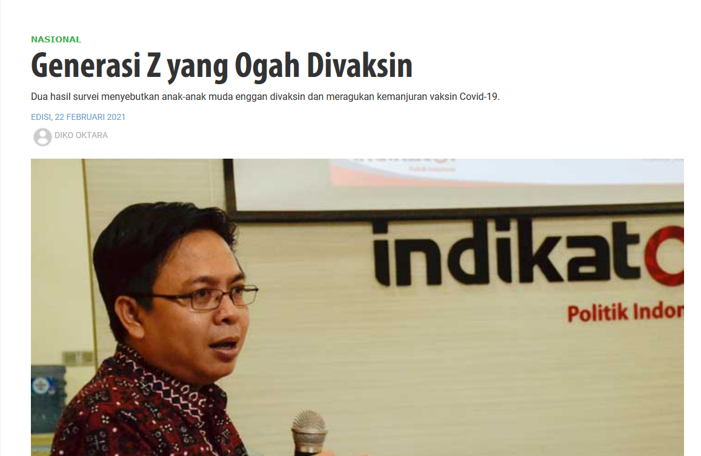
Survei Indikator Politik
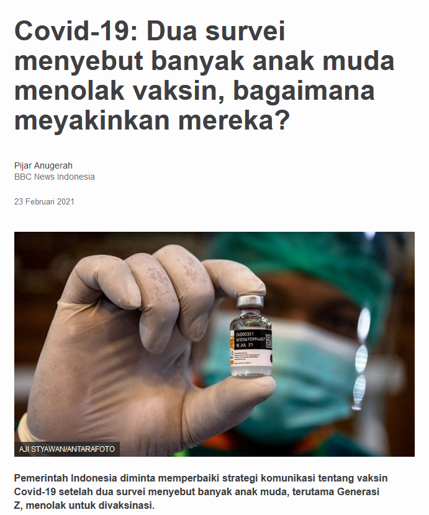
Mari kita lihat datanya
Sebuah lembaga survei mewawancarai 1.200 partisipan secara acak melalui telepon tentang kesediaan vaksinasi. Dari 1.200 partisipan, sekitar 118 orang (9.8%) berusia 22–25 tahun.
Klaim yang dipublikasikan media: hanya 45.1% partisipan usia 22–25 tahun bersedia divaksinasi, yang merupakan proporsi terendah di antara semua kelompok usia. Kesimpulan yang menjadi headline media: generasi muda (Gen Z) banyak menolak vaksinasi.
Survei Indikator
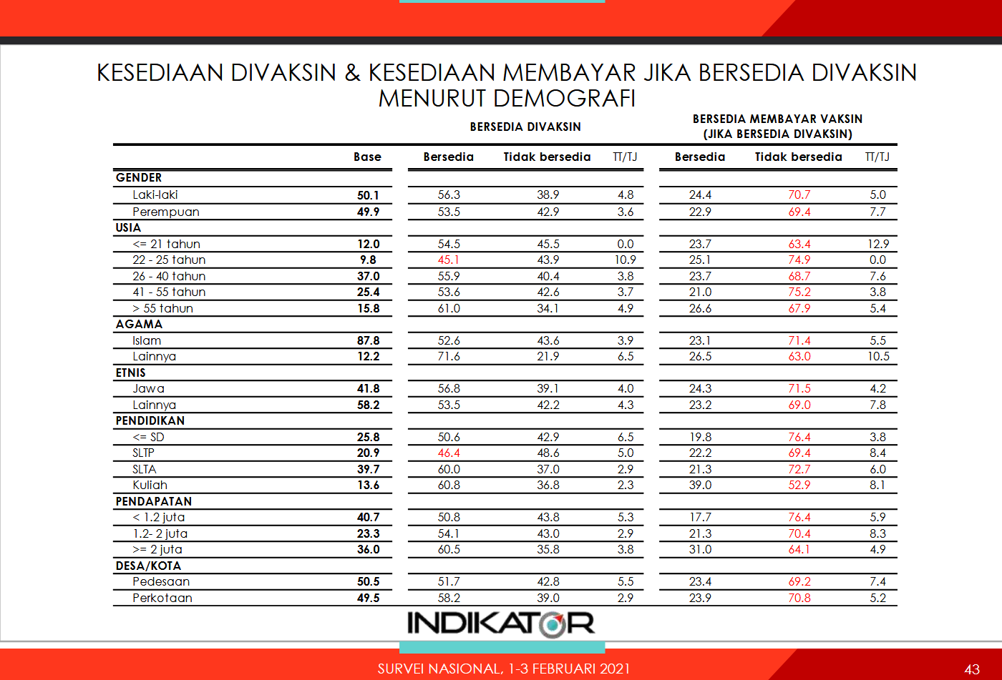
Persoalannya…
- Proporsi dari subkelompok kecil (n≈118) punya ketidakpastian jauh lebih besar daripada proporsi dari seluruh sampel, sehingga selisih beberapa poin persen antar kelompok usia bisa saja muncul karena kebetulan.
- Kesimpulan “Gen Z banyak menolak vaksin” hanya didasarkan pada kelompok usia 22–25 tahun, tanpa melibatkan partisipan usia 21 tahun ke bawah. Padahal, pada 2021 usia 22–25 tahun hanya sebagian yang termasuk Gen Z.
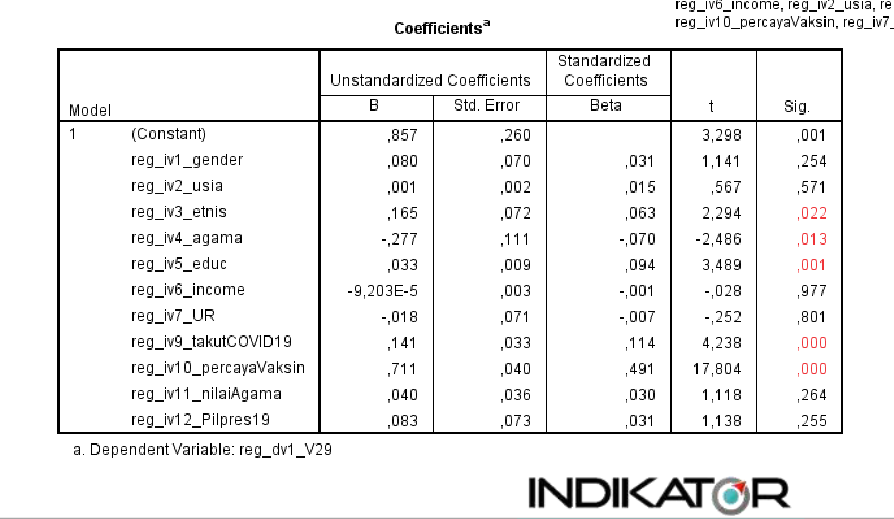
- Dalam analisis regresi (mengontrol variabel lain) dengan seluruh kelompok usia dilibatkan, hubungan usia dengan kesediaan vaksinasi ternyata sangat lemah dan tidak signifikan (lihat slide berikutnya).
Dalam analisis regresi, usia tidak signifikan
Kesimpulannya: Generalisasi Tergesa-Gesa
Generalisasi tergesa-gesa dari subkelompok (hasty generalization)
Menyimpulkan pola populasi dari satu subkelompok kecil yang estimasinya kurang presisi, tanpa mengecek apakah pola itu bertahan saat seluruh kelompok dilibatkan, adalah bentuk penyalahgunaan statistik yang, sayangnya, cukup sering terjadi.
Moral of the story: selalu cek kesesuaian antara klaim dan data. Kalau sebuah klaim terasa too good to be true (atau too alarming to be true), ini adalah indikasi bahwa Anda perlu memeriksa datanya lebih teliti.
Melaporkan Interval Kepercayaan 📏
Kenapa confidence interval penting
- Saat melaporkan hasil statistik, selalu sertakan interval kepercayaan (confidence interval, CI), bukan hanya point estimate-nya saja.
- CI memberi gambaran yang jauh lebih realistis tentang data dan ketidakpastian yang menyertainya.
- Melaporkan CI sangat dianjurkan di banyak komunitas akademik (mis. standar JARS dari APA), meski menerjemahkannya ke bahasa awam bukan pekerjaan mudah.
Bagaimana melaporkan CI dengan benar
Kembali ke kasus survei vaksinasi: peneliti hanya melaporkan point estimate (45.1%) dengan margin of error 2.9%.
Sebelum
“Hanya 45.1% partisipan berusia 22–25 tahun bersedia divaksinasi.”
Sesudah
“Dari sekitar 120 partisipan usia 22–25 tahun, hanya 45.1% yang bersedia divaksinasi (interval kepercayaan 95%: 42.2–48.0%). Jika survei ini diulang berkali-kali, sekitar 95% dari interval yang dihasilkan akan mencakup persentase populasi yang sebenarnya. Meski begitu, dalam analisis regresi yang mengontrol variabel lain, usia tidak berkaitan secara signifikan dengan kesediaan vaksinasi, sehingga belum ada bukti kuat bahwa kelompok usia ini benar-benar berbeda.”
Persoalannya
Masalahnya
Margin of error ±2.9% ini sebenarnya angka topline untuk seluruh sampel (n=1.200), untuk subkelompok usia 22–25 tahun (n≈120) margin of error-nya jauh lebih lebar (kira-kira ±9%). Inilah kesalahan pelaporan yang umum terjadi: memakai MoE survei keseluruhan untuk subkelompok yang jauh lebih kecil.
Seharusnya > “Dari sekitar 120 partisipan usia 22–25 tahun, hanya 45.1% yang bersedia divaksinasi (interval kepercayaan 95%: 36.1–54.1%). Jika survei ini diulang berkali-kali, sekitar 95% dari interval yang dihasilkan akan mencakup persentase populasi yang sebenarnya. Interval selebar ini masih tumpang tindih dengan interval kelompok usia lain (mis. usia ≤ 21 tahun: 54.5%; 26–40 tahun: 55.9%), sehingga belum ada bukti kuat bahwa kelompok usia ini benar-benar berbeda.”
Questionable Research Practices (QRP) ⚖️
QRP
- Menganalisis data bukan cuma soal keterampilan teknis, tetapi ada etika yang menyertainya.
- Questionable research practices (QRP) adalah praktik analisis yang secara teknis “tidak curang” tapi menyesatkan kesimpulan, dan menjadi salah satu penyebab utama krisis replikasi dalam psikologi (John et al., 2012).
- Dua bentuk QRP yang paling sering dibahas: p-hacking dan HARKing.
P-hacking
Definisi
Mengulik analisis dengan mencoba berbagai kombinasi variabel, metode, atau ambang batas, sampai ditemukan hasil yang signifikan secara statistik (p < ,05), lalu hanya melaporkan hasil yang signifikan saja (Simmons et al., 2011).
Contoh bentuknya:
- Membuang beberapa partisipan/observasi “yang mengganggu” hasil, tanpa alasan metodologis yang jelas.
- Mencoba berbagai cara mengelompokkan variabel (mis. usia dibagi 2 kelompok, lalu 3, lalu 4) sampai salah satu menghasilkan signifikansi.
- Menjalankan puluhan uji korelasi dan hanya melaporkan yang signifikan.
HARKing
Hypothesizing After the Results are Known
Menyajikan temuan yang sebenarnya ditemukan secara eksploratif (setelah melihat data) seolah-olah itu adalah hipotesis yang sudah dirumuskan sejak awal, sebelum data dikumpulkan (Kerr, 1998).
Ingat analysis plan dari Pertemuan 5? Salah satu fungsinya mencegah HARKing. Dengan mencatat hipotesis dan rencana analisis sebelum melihat hasilnya, Anda punya jejak yang jelas: mana yang confirmatory (diuji sesuai rencana) dan mana yang exploratory (ditemukan di tengah jalan).
Kenapa ini berisiko
- P-hacking menyebabkan tidak terkendalinya false positive rate — hasil yang terlihat signifikan padahal sebenarnya hanya “kebetulan” secara statistik (Simmons et al., 2011).
- HARKing membuat pembaca mendapatkan kesan bahwa sebuah hipotesis “berhasil diuji secara ketat”, padahal sebenarnya ditemukan lewat coba-coba.
- Keduanya berkontribusi pada krisis replikasi: banyak temuan populer dalam psikologi ternyata gagal direplikasi peneliti lain.
Penting diingat
Bandingkan dengan yang akan kita pelajari di Pertemuan 12: post hoc theorizing memang dibolehkan dalam narrative review yang mensintesis puluhan studi (Baumeister & Leary, 1997). Yang tidak boleh adalah menyamarkan eksplorasi sebagai konfirmasi dalam satu studi empiris tunggal.
Cara menjaga diri dari QRP
- Susun analysis plan sebelum melihat hasil (Pertemuan 5) — idealnya bahkan sebelum data dikumpulkan (preregistration).
- Laporkan semua analisis yang Anda coba, bukan hanya yang signifikan dan selalu termasuk yang “gagal”.
- Bedakan secara eksplisit dalam naskah Anda: mana temuan yang confirmatory (menguji hipotesis awal) dan mana yang exploratory (ditemukan setelah melihat data).
- Analisis eksploratif boleh dilaporkan, asal transparan disebut sebagai eksploratif, bukan disamarkan sebagai konfirmasi.
🧩 Aktivitas mandiri: Mengenali QRP
Perhatikan
Baca skenario berikut: “Seorang peneliti awalnya menguji apakah skor Neuroticism berkorelasi dengan usia. Hasilnya tidak signifikan. Peneliti lalu mencoba mengorelasikan usia dengan keempat trait lainnya satu per satu, dan menemukan korelasi signifikan dengan Openness. Dalam naskahnya, peneliti menulis: ‘Kami menghipotesiskan bahwa usia berkaitan dengan Openness, dan hipotesis ini terbukti.’”
- Identifikasi QRP apa yang terjadi di sini — p-hacking, HARKing, atau keduanya?
- Bagaimana seharusnya peneliti ini melaporkan temuannya secara transparan?
Penutup
Kesimpulan Pertemuan 6
- Cara melaporkan temuan bergantung pada audiens: komunitas akademik, informed lay public, atau general lay public.
- Hedging language menyesuaikan tingkat kepastian narasi Anda dengan kekuatan bukti yang sebenarnya.
- Jangan terlalu firm, jangan juga terlalu terbaca ragu-ragu.
- Generalisasi tergesa-gesa (i.e., hasty generalization) dapat memberikan impresi yang keliru ketika membaca data.
- Selalu laporkan interval kepercayaan, bukan hanya point estimate.
- Waspadai p-hacking dan HARKing — analysis plan dari Pertemuan 5 adalah pertahanan utama Anda.
Referensi
- Baumeister, R. F., & Leary, M. R. (1997). Writing narrative literature reviews. Review of General Psychology, 1(3), 311–320. https://doi.org/10.1037/1089-2680.1.3.311
- John, L. K., Loewenstein, G., & Prelec, D. (2012). Measuring the prevalence of questionable research practices with incentives for truth telling. Psychological Science, 23(5), 524–532. https://doi.org/10.1177/0956797611430953
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Open-Source Psychometrics Project. (n.d.). Open psychology data: Raw data from online personality tests. https://openpsychometrics.org/_rawdata/
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Terima kasih!😊
Ada pertanyaan?
- amelia.zein@psikologi.unair.ac.id
- https://rameliaz.github.io/
- @rameliaz
- @rameliaz
- @rameliaz
Paparan disusun dengan menggunakan dan Quarto dengan template dari UNAIR Theme.