Format Respons II: Thurstone, Situational Judgement Test, dan Forced-Choice
Penyusunan Skala Psikologi
2026-09-29
Agenda
- 3️⃣ asumsi pengukuran yang selama ini diterima begitu saja
- Thurstone: item yang sudah dikalibrasi lebih dulu oleh panel
- Situational Judgement Test: mengukur penilaian atas situasi, bukan pernyataan tentang diri sendiri (self-report)
- Forced-choice: partisipan dipaksa memilih, dan skornya menjadi ipsatif
- Kenapa data ipsatif berlawanan dengan hampir semua asumsi yang kita pelajari di Pertemuan 3
3️⃣ asumsi yang selama ini diterima begitu saja
Yang belum dijelaskan di pertemuan sebelumnya
Ketika kita memakai skala Likert, secara implisit kita menerima 3️⃣ hal:
Semua item berbobot sama. Item nomor 1 dan nomor 7 sama-sama bernilai maksimum 5 poin.
Item berupa pernyataan tentang diri sendiri (self-report), secara abstrak. (misalnya, “Saya orang yang teliti.”)
Setiap item dijawab secara terpisah. Menyetujui satu item tidak memaksa partisipan menolak item lain.
Hari ini kita akan mempelajari tiga format respons yang masing-masing menolak salah satu dari asumsi ini.
Format respons dan asumsi Likert yang ditolak
| Format | Yang ditolak | Yang diperoleh |
|---|---|---|
| Thurstone | Bobot item yang sama | Item terkalibrasi di sepanjang kontinum |
| SJT | Pernyataan tentang diri sendiri yang cenderung abstrak | Konteks dan penilaian yang lebih konkret |
| Forced-choice | Kebebasan menjawab tiap item | Menangkal masalah social desirability |
Ketiganya kelihatannya menarik secara konseptual, tetapi jauh lebih sulit dikembangkan daripada Likert, dan dua di antaranya berlawanan dengan asumsi yang kita bangun di Pertemuan 3.
Thurstone
Analogi garpu tala
Sebuah garpu tala dirancang bergetar pada frekuensi tertentu. Kalau ada nada dengan frekuensi yang sama di dekatnya, garpu itu ikut bergetar. Kalau frekuensinya berbeda, ia diam.
Bayangkan sederet garpu tala yang tersusun dari frekuensi rendah ke tinggi. Untuk mengetahui frekuensi sebuah nada, Anda cukup melihat garpu mana yang bergetar.
Skala Thurstone bekerja persis seperti ini: tiap item “disetel” untuk merespons level atribut (\(\theta\)) tertentu.
Bandingkan dengan Likert: semua item pada dasarnya adalah detektor yang sama dan yang berbeda hanya derajat pilihan responsnya.
Bagaimana skala Thurstone dibuat
Kumpulkan banyak pernyataan tentang objek sikap, yang biasanya puluhan hingga ratusan.
Minta anggota panel menempatkan tiap pernyataan ke dalam 11 kategori, dari paling bertentangan sampai paling mendukung konstruk.
- Anggota panel tidak diminta pendapat pribadinya; mereka diminta menilai posisi pernyataannya di garis kontinum level atribut (\(\theta\)).
Hitung median penilaian anggota panel untuk tiap pernyataan.
- Inilah yang dijadikan nilai skala (scale value) pernyataan tersebut.
Hitung sebaran penilaian anggota panel (rentang antarkuartil). Pernyataan yang tidak disepakati anggota panel berarti ambigu, dan dibuang.
Pilih pernyataan yang tersisa sedemikian rupa sehingga nilai skalanya tersebar merata di sepanjang kontinum level atribut (\(\theta\)).
Seperti apa hasilnya
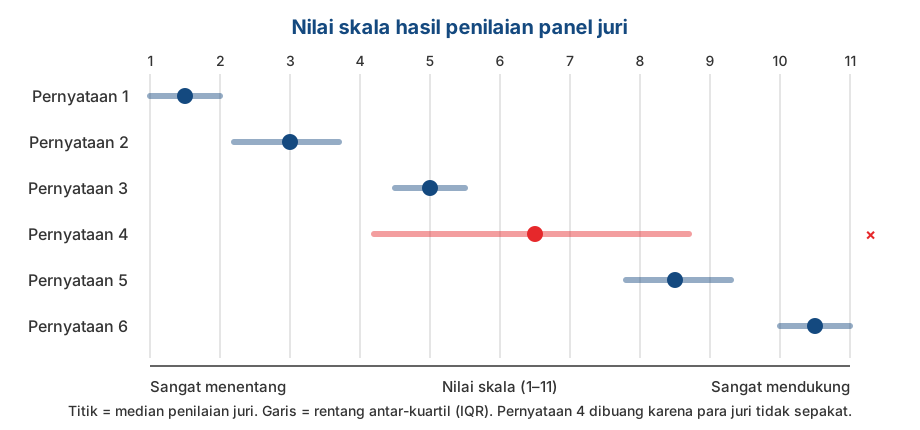
Membaca ilustrasi sebelumnya
- Tiap pernyataan punya satu angka yang menandai posisinya di kontinum.
- Angka inilah yang mencerminkan kalibrasinya.
- Pernyataan 4 punya rentang antarkuartil yang sangat lebar: para anggota panel tidak sepakat pernyataan itu ada di posisi mana.
- Pernyataan seperti ini sebaiknya dibuang, sebagus apa pun penulisan kalimatnya.
- Pernyataan yang lolos harus tersebar dari ujung ke ujung kontinum level atribut (\(\theta\)), sehingga merepresentasikan seluruh spektrum konstruk.
Pembuat skala sudah menentukan “tingkat kesulitan” tiap item sebelum partisipan mengisinya. Ini adalah sesuatu yang tidak bisa dilakukan dengan CTT.
Cara partisipan menjawab dan cara menskornya
Partisipan hanya diminta setuju atau tidak setuju (ya/tidak) pada tiap pernyataan.
Skor partisipan adalah rata-rata (atau median) nilai skala dari pernyataan yang ia setujui.
Jadi orang yang menyetujui dua pernyataan dengan nilai skala masing-masing 8,5 dan 10,5 akan mendapat skor 9,5.
Apa perbedaannya dengan Likert?
Pada Likert, informasi ada pada derajat jawaban. Pada Thurstone, informasi ada pada item mana yang disetujui.
Kenapa Thurstone jarang dipakai
Lebih sulit dibuat. Anda perlu panel reviewer sebelum satu pun data partisipan dikumpulkan.
Menemukan item yang benar-benar “beresonansi” pada level tertentu jauh lebih sulit daripada membayangkannya.
Nunnally (1978), sebagaimana dikutip DeVellis, menilai bahwa masalah praktisnya sering lebih besar daripada keuntungannya, kecuali kalau peneliti benar-benar membutuhkan kalibrasi seperti yang diilustrasikan oleh Thurstone.
Konsekuensi teoretisnya
Seperti Guttman di Pertemuan 4, item Thurstone tidak berbobot sama. Artinya model parallel dan tau-equivalent dari Pertemuan 3 tidak berlaku, dan Cronbach’s \(\alpha\) tidak tepat dipakai sebagai estimasi reliabilitas skornya.
Tetapi gagasannya tetap bermanfaat dalam dua hal
- Pengembangan model IRT. Metode berbasis IRT punya tujuan yang sama dengan Thurstone.
- Parameter lokasi item \(b\) yang kita lihat di Pertemuan 3 punya peran yang mirip dengan nilai skala Thurstone, tetapi IRT mengestimasinya dari data partisipan, bukan dari panel reviewer.
- Catatan: item Thurstone mengikuti model ideal point (peluang setuju paling besar di sekitar posisi item, seperti garpu tala tadi), sedangkan model IRT yang umum adalah model dominansi (peluang setuju terus naik seiring \(\theta\)).
- Untuk proyek pengembangan skala Anda. Di Pertemuan 11, Anda akan meminta panel ahli menilai relevansi tiap item, lalu menghitung Content Validity Index.
Perhatikan kemiripannya
Prosedur CVI adalah logika Thurstone yang diterapkan pada relevansi item dengan substansi konstruk, bukan pada posisi item di kontinum level atribut (\(\theta\)).
Situational Judgement Test
Bentuknya
Partisipan diberi skenario yang realistis, lalu diminta menilai beberapa kemungkinan tindakan.
Yang diukur bukan pernyataan tentang diri sendiri (self-report), melainkan penilaian dalam situasi konkret.
Berakar sejak 1920-an (Moss, 1926), dipakai luas oleh militer AS pada Perang Dunia II, dan populer kembali sejak Motowidlo dkk. (1990) menyebutnya sebagai low-fidelity simulation.
Contoh
Situasi. Anda memimpin kelompok tugas beranggotakan lima orang. Dua hari sebelum tenggat, satu anggota memberi tahu bahwa bagiannya belum dikerjakan sama sekali karena ada urusan keluarga.
Seberapa efektif tiap tindakan berikut?
| Tindakan | Respons partisipan (1: sama sekali tidak efektif; 5: sangat efektif) | |
|---|---|---|
| A | Mengerjakan sendiri bagian itu agar tenggat terkejar | 1–5 |
| B | Membagi bagian tersebut ke anggota lain yang sudah selesai | 1–5 |
| C | Meminta perpanjangan waktu kepada dosen | 1–5 |
| D | Menyerahkan tugas apa adanya dan menuliskan siapa yang tidak berkontribusi | 1–5 |
Perhatikan perbedaannya
“Apa yang akan Anda lakukan?”
Mengukur kecenderungan perilaku.
Lebih dekat ke kepribadian.
Lebih rawan “ditutupi” partisipan.
“Apa yang sebaiknya dilakukan?”
Mengukur pengetahuan tentang tindakan yang efektif.
Lebih dekat ke kemampuan kognitif.
Lebih tahan terhadap social desirability.
Ployhart & Ehrhart (2003) menunjukkan bahwa mengganti instruksi respons mengubah reliabilitas skor dan konstruk yang terukur.
Cara menskornya
Berbasis konsensus — kunci jawabannya diambil dari rata-rata penilaian sampel besar.
Berbasis ahli — panel praktisi menentukan mana tindakan yang efektif.
Berbasis teori — kunci diturunkan dari teori tentang konstruk yang diukur.
Perhatikan bahwa kunci berbasis ahli membutuhkan panel, persis seperti Thurstone dan seperti CVI nanti di Pertemuan 11. Kunci berbasis konsensus memakai sampel besar sebagai “panel”-nya.
Kelebihannya
Konteks yang konkret. Partisipan tidak diminta menggeneralisasi tentang dirinya, melainkan menanggapi situasi tertentu.
- Ini menghindari sebagian masalah akses introspektif dari Pertemuan 2.
Tampak relevan bagi partisipan, sehingga lebih mudah diterima dalam konteks seleksi.
Prediksi kinerja yang cukup baik. McDaniel dkk. (2001) menunjukkan SJT memprediksi job performance secara memadai.
Masalah psikometriknya
SJT hampir selalu multidimensional. Satu skenario bisa sekaligus melibatkan pengetahuan, kepribadian, dan penalaran.
Akibatnya, konsistensi internalnya sering rendah.
Ini melanggar asumsi unidimensionalitas dari Pertemuan 2, dan membuat model CTT di Pertemuan 3 perlu diperluas.
Kesalahan yang umum
Melaporkan Cronbach’s \(\alpha\) untuk SJT lalu menyimpulkan skor tesnya kurang reliabel karena koefisiennya rendah.
\(\alpha\) mengasumsikan semua item digerakkan oleh satu variabel laten yang sama. Pada SJT, asumsi itu memang tidak dimaksudkan untuk terpenuhi. Koefisien yang tidak sesuai dengan struktur datanya menghasilkan kesimpulan yang keliru.
Forced-choice
Masalah yang ingin dipecahkan
Ingat asumsi keenam dari Pertemuan 2: partisipan mau melaporkan keadaannya apa adanya.
Pada konteks seleksi kerja, asumsi itu jelas tidak realistis. Semua orang punya alasan untuk menampilkan dirinya sebaik mungkin.
Dengan format Likert, partisipan bisa memberi nilai tinggi pada semua pernyataan yang terbaca baik.
Gagasan inti forced-choice
Kalau partisipan dipaksa memilih di antara dua pernyataan yang sama-sama menarik, ia tidak bisa lagi sekadar menyetujui semuanya. Ia harus mengungkapkan mana yang lebih menggambarkan dirinya.
Bentuknya
Pilih satu pernyataan yang paling menggambarkan diri Anda:
| (a) | Saya suka menyelesaikan pekerjaan tepat waktu. |
| (b) | Saya suka membantu orang lain menyelesaikan masalahnya. |
Kedua pernyataan sama-sama positif. Tidak ada jawaban yang jelas “lebih baik”.
Keduanya mengukur konstruk yang berbeda. Di dua item ini kira-kira ketelitian dan keramahan.
Variasi lain: blok berisi tiga atau empat pernyataan, dengan instruksi “paling menggambarkan saya” dan “paling tidak menggambarkan saya”.
Syarat penyusunan forced-choice
Pasangan pernyataan harus disetarakan tingkat kemenarikannya lebih dulu, dan ini membutuhkan penelitian preliminary tersendiri.
Kalau tidak disetarakan, format ini tidak menyelesaikan masalah social desirability: partisipan akan tetap memilih yang terdengar lebih baik.
Proses menyetarakan kemenarikan sama dengan mengalibrasi item.
- Sekali lagi, mirip dengan Thurstone.
Risiko yang harus diterima: ipsativitas
Setiap kali partisipan memilih satu pernyataan, ia otomatis tidak memilih yang lain.
Akibatnya, skor total semua skala menjadi konstan untuk setiap partisipan.
- Kalau skor satu skala naik, skor skala lain harus turun.
Data dengan sifat ini disebut ipsatif: skornya bermakna di dalam diri seseorang, bukan antarorang.
Pada data ipsatif, skor menjawab pertanyaan “dari semua hal ini, mana yang paling menonjol pada diri saya?”, sedangkan untuk Likert: “seberapa banyak sifat konstruk ini saya miliki dibandingkan orang lain?”
Kenapa ini memperumit analisis
Karena skor totalnya dipaksa konstan, korelasi antarskala dipaksa menjadi negatif, bahkan kalau konstruk yang sesungguhnya sama sekali tidak berhubungan.
Untuk instrumen ipsatif dengan \(k\) skala (dengan asumsi varians tiap skala setara), rata-rata korelasi antarskalanya adalah:
\[\bar{r} = -\frac{1}{k-1}\]
| Jumlah skala (\(k\)) | Rata-rata korelasi yang dipaksakan |
|---|---|
| 3 | −0,50 |
| 5 | −0,25 |
| 10 | −0,11 |
Koefisien-koefisien ini lebih banyak dijelaskan oleh format skalanya, bukan oleh proses psikologis partisipan yang ingin diukur.
Konsekuensinya
Skor tidak bisa dibandingkan antarorang. Skor 8 pada skala ketelitian milik A tidak bisa langsung dibandingkan dengan skor 8 milik B.
Analisis faktor menjadi menyesatkan, karena struktur korelasinya sudah diganggu lebih dulu oleh formatnya.
Koefisien reliabilitas klasik jadi sulit ditafsirkan. Model CTT di Pertemuan 3 mengandaikan skor yang bebas bergerak, sedangkan skor forced-choice sudah dibatasi oleh formatnya.
Instrumen ipsatif tidak boleh dipakai untuk seleksi, pemeringkatan, atau perbandingan antarindividu.
Ada jalan keluarnya
Brown & Maydeu-Olivares (2011) menunjukkan bahwa dengan pemodelan IRT, skor normatif bisa dipulihkan dari respons forced-choice.
Pendekatannya disebut Thurstonian IRT, karena berangkat dari model Thurstone tentang perbandingan berpasangan (law of comparative judgement; Thurstone, 1927).
Jadi format ini tetap bisa dipakai, asalkan analisisnya memakai model yang tepat, bukan penjumlahan sederhana.
Model perbandingan berpasangan Thurstone (law of comparative judgement, 1927) — bukan metode panel yang kita bahas di awal — ternyata menjadi dasar solusi untuk masalah ini.
Apa yang realistis untuk proyek Anda
Seberapa realistis ketiganya untuk proyek Anda
Thurstone — masih realistis, tetapi lebih sulit secara teknis dibandingkan membuat skala Likert.
SJT — tidak realistis. Menulis skenario yang baik dan menyusun kunci jawabannya adalah penelitian empiris tersendiri.
Forced-choice — tidak realistis. Analisis yang benar untuk data ipsatif berada di luar cakupan mata kuliah ini.
Lalu mengapa dibahas?
Karena Anda akan menemui ketiganya dalam praktiknya, terutama SJT dan forced-choice, yang banyak dipakai dalam asesmen dan seleksi kerja di Indonesia.
Oleh karena itu, Anda perlu dibekali kemampuan untuk menilai apakah alat semacam ini dipakai secara benar.
Demo dan latihan
Bagian 1: menjadi reviewer untuk item Thurstone
Objek sikap: penggunaan AI untuk mengerjakan tugas kuliah.
Nilai tiap pernyataan berikut dari 1 (sangat menentang) sampai 11 (sangat mendukung). Nilai posisi pernyataannya, bukan pendapat pribadi Anda.
- Memakai AI untuk tugas kuliah adalah kecurangan, apa pun alasannya.
- AI sebaiknya hanya dipakai untuk memeriksa tata bahasa.
- AI boleh dipakai mencari referensi, asalkan tulisannya tetap karya sendiri.
- Memakai AI sama saja dengan memakai kalkulator: sekadar alat bantu.
- Mahasiswa yang tidak memakai AI akan tertinggal.
- Tugas sebaiknya dinilai dari hasil akhirnya saja, tidak peduli bagaimana dibuat.
Bagian 1: apa yang dihitung dan didiskusikan
Hitung median penilaian kelas untuk tiap pernyataan. Itulah nilai skalanya.
Hitung rentang antarkuartil tiap pernyataan. Mana yang paling tidak disepakati?
Pernyataan mana yang akan Anda buang, dan kenapa?
Apakah pernyataan yang tersisa tersebar merata di sepanjang kontinum, atau menumpuk di satu sisi?
Perhatikan bahwa Anda baru saja menjalankan prosedur yang sama dengan yang akan Anda pakai untuk CVI di Pertemuan 11, hanya saja kriterianya yang berbeda.
Bagian 2: menyetarakan kemenarikan
Perhatikan tiga pasangan forced-choice berikut. Mana yang sudah disetarakan dengan baik, mana yang belum?
Pasangan 1 (a) Saya orang yang teratur. (b) Saya orang yang mudah bergaul.
Pasangan 2 (a) Saya suka merencanakan segala sesuatu. (b) Saya kadang menunda pekerjaan.
Pasangan 3 (a) Saya menikmati bekerja sendirian. (b) Saya menikmati bekerja dalam tim.
Untuk pasangan yang belum setara, tuliskan bagaimana Anda memperbaikinya.
Rangkuman
Enam poin utama
Thurstone mengalibrasi item lebih dulu lewat panel reviewer, sehingga item punya posisi yang diketahui di kontinum level atribut (\(\theta\)).
Nilai skala Thurstone punya peran yang mirip dengan parameter lokasi item dalam IRT (walaupun Thurstone memakai model ideal point), dan prosedur expert reviewnya menginspirasi prosedur penilaian reviewer dalam proses penghitungan CVI.
SJT mengukur penilaian dalam konteks, dan konstruknya hampir selalu multidimensional, sehingga Cronbach’s \(\alpha\) yang rendah tidak otomatis menandakan masalah.
Instruksi respons pada SJT mengubah konstruk yang terukur. “Akan saya lakukan” dan “apa yang sebaiknya dilakukan” bukan hal yang sama.
Forced-choice mengurangi pengaruh social desirability, tetapi menghasilkan data ipsatif.
Data ipsatif membuat korelasi antarskala menjadi negatif dan membuat perbandingan antarorang sulit dilakukan.
- Tetapi, data ini dapat dikoreksi dengan teknik pemodelan yang tepat (Thurstonian IRT).
Untuk Pertemuan 6
Setelah lima pertemuan membicarakan konsep dan format, kita mulai menghitung: reliabilitas.
- Rumus Spearman-Brown yang sudah dua kali kita tunda.
- Cronbach’s alpha dan asumsi tau-equivalent yang jarang terpenuhi.
- Koefisien omega dan kenapa umumnya lebih tepat.
- Test-retest, alternate forms, dan konsistensi internal: tiga pertanyaan yang berbeda, bukan tiga cara menghitung hal yang sama.
- Koefisien mana yang sebaiknya Anda laporkan di laporan proyek.
Persiapan
Baca DeVellis & Thorpe (2022), Bab 3. Kalau ingin melihat versinya dalam praktik, bab Reliability pada Bikos menunjukkan berbagai koefisien secara berdampingan.
Terima kasih!😊
Ada pertanyaan?
- amelia.zein@psikologi.unair.ac.id
- https://rameliaz.github.io/
- @rameliaz
- @rameliaz
- @rameliaz
Paparan disusun dengan menggunakan dan Quarto dengan template dari UNAIR Theme.
Rujukan
Brown, A., & Maydeu-Olivares, A. (2011). Item response modeling of forced-choice questionnaires. Educational and Psychological Measurement, 71(3), 460–502.
DeVellis, R. F., & Thorpe, C. T. (2022). Scale development: Theory and applications (5th ed.). SAGE.
Edwards, A. L. (1959). Edwards Personal Preference Schedule manual. Psychological Corporation.
Hicks, L. E. (1970). Some properties of ipsative, normative, and forced-choice normative measures. Psychological Bulletin, 74(3), 167–184.
McDaniel, M. A., Morgeson, F. P., Finnegan, E. B., Campion, M. A., & Braverman, E. P. (2001). Use of situational judgment tests to predict job performance. Journal of Applied Psychology, 86(4), 730–740.
Moss, F. A. (1926). Do you know how to get along with people? Scientific American, 135(1), 26–27. https://doi.org/10.1038/scientificamerican0726-26
Motowidlo, S. J., Dunnette, M. D., & Carter, G. W. (1990). An alternative selection procedure: The low-fidelity simulation. Journal of Applied Psychology, 75(6), 640–647.
Nunnally, J. C. (1978). Psychometric theory (2nd ed.). McGraw-Hill.
Ployhart, R. E., & Ehrhart, M. G. (2003). Be careful what you ask for: Effects of response instructions on the construct validity and reliability of situational judgment tests. International Journal of Selection and Assessment, 11(1), 1–16.
Thurstone, L. L. (1927). A law of comparative judgment. Psychological Review, 34(4), 273–286. https://doi.org/10.1037/h0070288
Thurstone, L. L. (1928). Attitudes can be measured. American Journal of Sociology, 33(4), 529–554.
Thurstone, L. L., & Chave, E. J. (1929). The measurement of attitude. University of Chicago Press.
Whetzel, D. L., & McDaniel, M. A. (2009). Situational judgment tests: An overview of current research. Human Resource Management Review, 19(3), 188–202.