Menggunakan Akal Imitasi untuk Penelitian Tugas Akhir

Mini-Workshop Persiapan Tesis untuk Mahasiswa Magister Psikologi

2026-09-25

Agenda

  1. Apa sebenarnya akal imitasi?
  2. Bagaimana dan untuk apa peneliti memakai AI? Bukti dari riset
  3. AI Fluency Framework — mengapa fluency menentukan kualitas output
  4. Di tahap penelitian mana AI bisa membantu?
  5. Risiko dan mitigasinya
  6. Kesimpulan

Perlu diketahui

Mungkin kursus ini juga menarik?
Apa Sebenarnya Akal Imitasi? 🤖

Artificial intelligence alias “akal imitasi”

  • Banyak orang menerjemahkan artificial intelligence sebagai “kecerdasan buatan”, sehingga publik mengira AI benar-benar cerdas
  • Padahal chatbot AI adalah model statistik dengan output teks (large language model, LLM) yang meniru proses dan produk kognisi manusia
  • Istilah akal imitasi mengingatkan dua hal: output-nya terasa alami dan meyakinkan, tapi LLM bukan manusia dan tidak punya pemahaman, niat, atau tanggung jawab dalam arti manusiawi
  • Konsekuensinya: Andalah yang bertanggung jawab atas apa pun yang dihasilkan AI dan Anda pakai dalam tugas akhir Anda

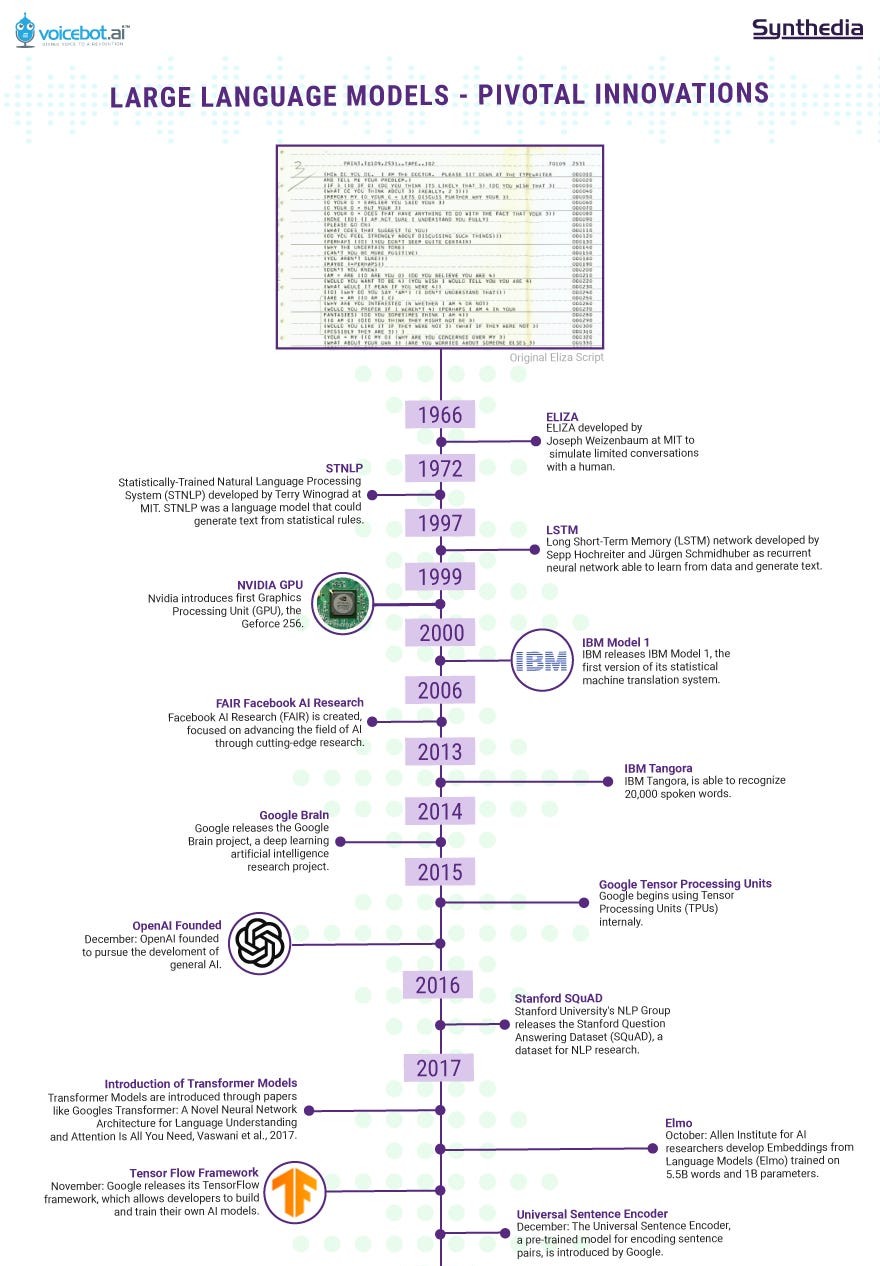
Sejarah singkat AI

  • 1950-an–1980-an: AI simbolik, manusia menuliskan aturan logikanya satu per satu (expert systems)
  • 1990-an–2000-an: machine learning membuat keputusan berdasarkan data (mis. penyaring spam)
  • 2010-an: deep learning dan pemrosesan bahasa alami (natural language processing) semakin matang
  • 2017: arsitektur transformer, titik balik yang memungkinkan LLM modern
  • 2022: OpenAI merilis ChatGPT (berbasis GPT-3.5); AI generatif menjadi fenomena massal
  • LIhat visualisasi perkembangan Google AI di sini.
Cara kerja LLM

Large language model (LLM) pada intinya adalah model statistik raksasa dengan output teks yang menjawab satu pertanyaan:

“Berdasarkan semua kata dalam percakapan ini, kata (token) apa yang paling mungkin muncul berikutnya?”
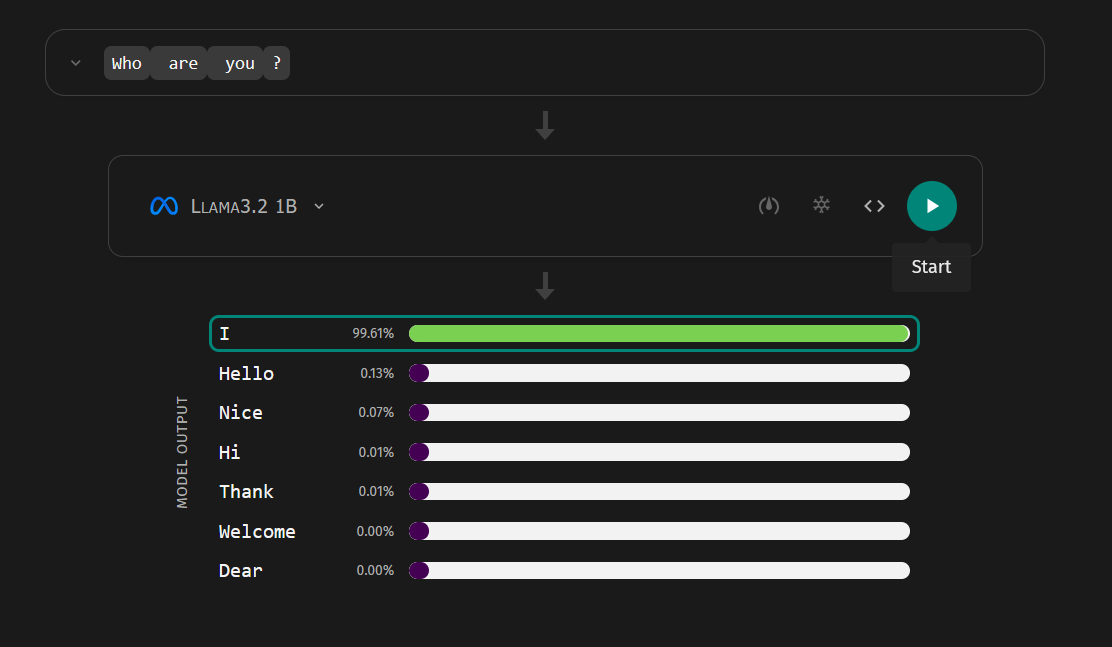
Klik di sini ➡️ AnimatedLLM

Kenapa LLM bisa “paham” konteks kalimat

Contoh: “Bisa ular itu amat mematikan” vs. “Saya bisa datang besok.”

  • Kata yang sama dengan makna berbeda (homonim), bergantung pada konteks kalimatnya
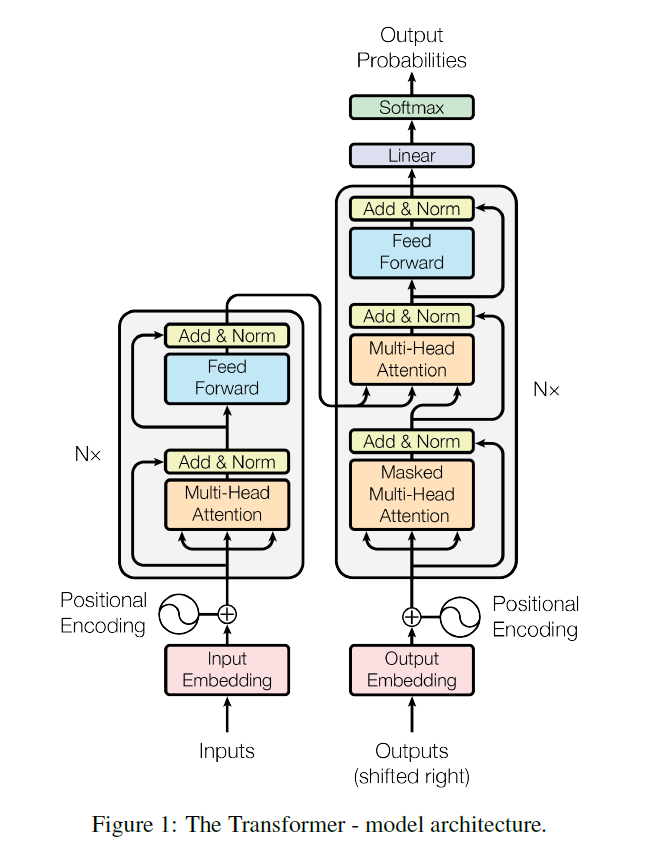
  • Arsitektur transformer memungkinkan setiap kata “memperhatikan” (attention) semua kata lain dalam konteks, bukan cuma kata sebelumnya
  • Ini juga yang membuat pelatihan LLM bisa dilakukan paralel dalam skala masif
Bagaimana LLM dikembangkan?

  1. Pre-training — model membaca miliaran contoh teks dan belajar memprediksi kata berikutnya; hasilnya “pengetahuan” bahasa dan dunia yang luas, tapi belum bisa berperilaku sebagai asisten
  2. Fine-tuning — pelatihan tambahan (termasuk dengan umpan balik manusia) agar model mengikuti instruksi, merespons dengan nada membantu, dan menolak permintaan yang berisiko
  3. Deployment — Anda memberi prompt, model merespons berdasarkan gabungan pola dari pelatihan dan konteks yang Anda berikan

Analoginya dengan proses belajar manusia

Pre-training ≈ pemerolehan bahasa dan pengetahuan. Fine-tuning ≈ sosialisasi, yaitu belajar norma tentang bagaimana menggunakan kemampuan itu secara pantas.

Kenapa kemampuannya melonjak drastis sejak 2022?

  • Arsitektur — transformer bisa diskalakan; semakin besar modelnya, semakin baik performanya, dalam pola yang cukup terprediksi (scaling laws)
  • Data — ledakan teks digital yang tersedia untuk dilatih (situs web, buku, kode)
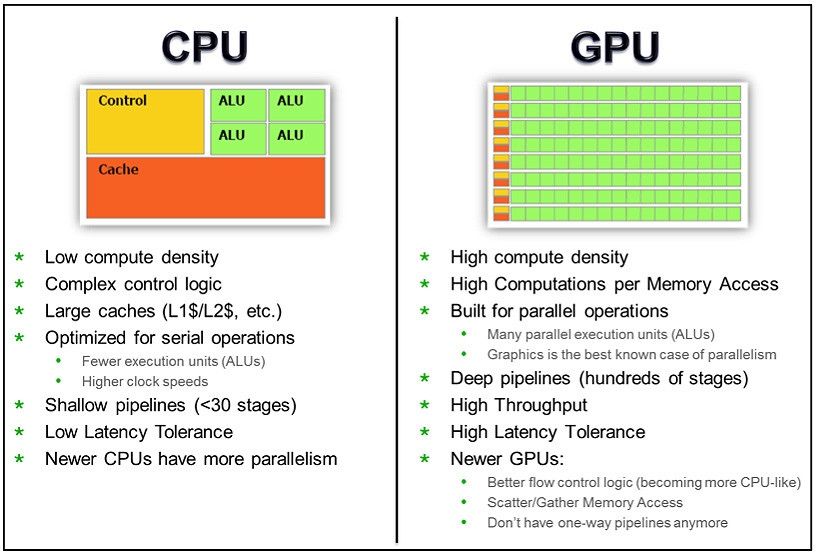
  • Daya Komputasi — GPU dan data center yang dibutuhkan untuk melatih LLM dengan parameter raksasa
Emergent capabilities

Pada ambang skala tertentu, kemampuan baru bisa muncul tanpa pernah diprogram secara eksplisit, misalnya kemampuan menerjemahkan atau menalar bertahap. Ini salah satu alasan perilaku LLM sulit diprediksi sepenuhnya.

Chatbot, reasoning model, dan agent

  • Chatbot — merespons pesan demi pesan, menunggu instruksi Anda di setiap langkah.
  • Reasoning model — “berpikir” bertahap sebelum menjawab, biasanya menghasilkan jawaban lebih terstruktur untuk masalah kompleks.
  • AI agent — merencanakan dan mengeksekusi tugas multi-langkah secara otonom atas nama Anda (menjelajah web, memakai aplikasi, menjalankan kode), dengan pengawasan yang jauh lebih longgar
    • Hanya menghasilkan performa optimal ketika menggunakan model frontier. Model lightweight masih bisa digunakan, tetapi harus diberi guardrail.
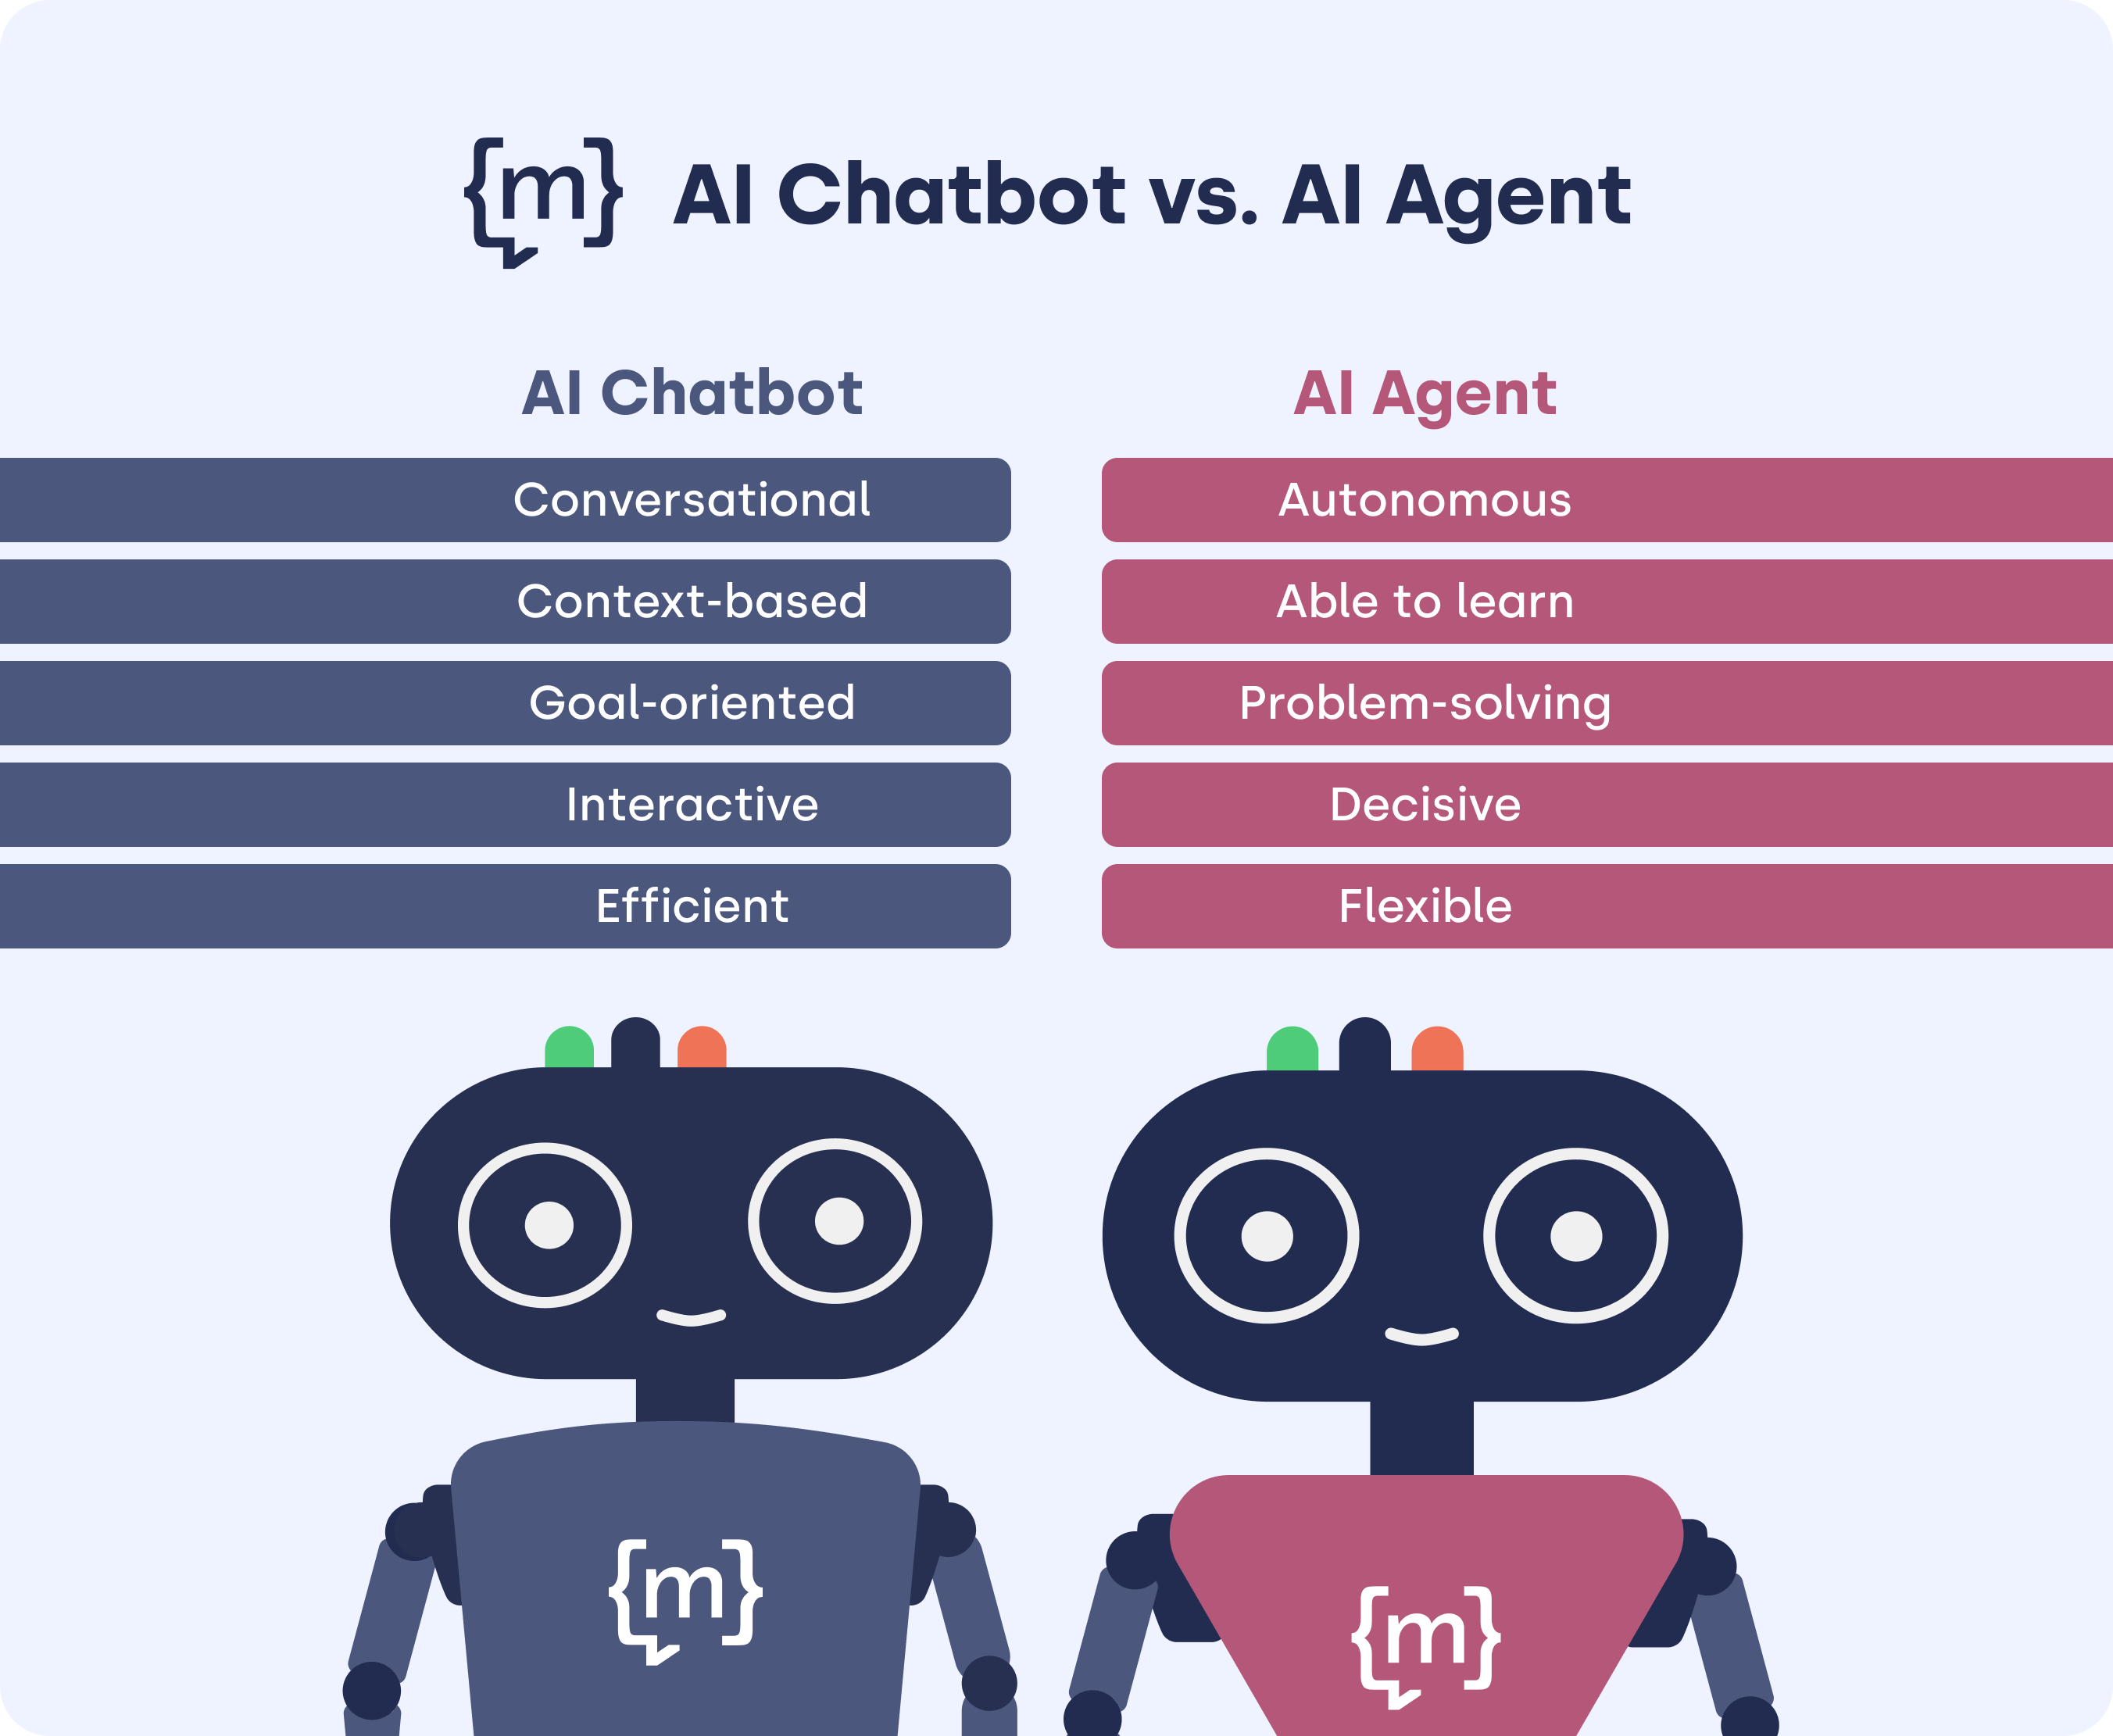
Kenapa ini penting untuk riset Anda

Beberapa alat bantu riset (lihat bagian selanjutnya) sudah berbentuk agent. Semakin otonom alatnya, semakin besar juga tanggung jawab Anda untuk memeriksa apa yang sudah dikerjakannya.

Keterbatasan LLM 🚩🚩🚩

  • Halusinasi — menyatakan sesuatu yang salah dengan nada percaya diri yang sama seperti saat ia benar, termasuk mengarang kutipan/rujukan yang terdengar meyakinkan tapi tidak pernah ada
  • Batas pengetahuan (knowledge cutoff) — model tidak tahu apa pun yang terjadi setelah tanggal terakhir data latihnya, kecuali diberi akses pencarian web
  • Batas konteks — ada jumlah maksimum teks yang bisa “diingat” model dalam satu sesi
  • Penalaran yang rapuh — perubahan kecil pada cara Anda merumuskan pertanyaan bisa menghasilkan jawaban yang sangat berbeda
  • Sycophancy — kecenderungan menyenangkan pengguna (menyetujui, memvalidasi) alih-alih jujur mengoreksi kesalahan Anda

Bagaimana dan Untuk Apa Peneliti Menggunakan AI? 📊

Arus utama dalam hitungan tiga tahun

  • ChatGPT diluncurkan November 2022. Per Juli 2025: sekitar 18 miliar pesan per minggu, dari sekitar 700 juta pengguna, kira-kira 1 dari 10 orang dewasa di dunia.
  • Proporsi pemakaiannya bergeser: pada Juni 2024, pemakaian untuk pekerjaan vs. di luar pekerjaan hampir seimbang (47% vs. 53%). Setahun kemudian, pemakaian non-kerja mendominasi (73%).
  • Tiga kategori percakapan terbesar: mencari panduan praktis (±29%), mencari informasi (±24%), dan menulis (±24%); totalnya sekitar 77% dari seluruh pemakaian.

Tiga cara orang memakai AI

  • Asking — meminta informasi atau saran, keputusan tetap di tangan manusia.
  • Doing — meminta AI menghasilkan atau menyelesaikan sesuatu secara langsung.
  • Expressing — memakai AI untuk memproses pikiran/perasaan.
  • Khusus pemakaian untuk pekerjaan, Doing mendominasi (±56%): orang lebih banyak meminta AI mengerjakan daripada menyarankan

Yang perlu Anda waspadai

Semakin besar porsi Doing dibanding Asking, semakin besar pula risiko Anda menyerahkan proses evaluasi output ke AI. Kita bahas lagi di bagian Discernment.

Bagaimana dengan peneliti?

  • Survei Nature terhadap 1.659 peneliti (2023): 48% mengembangkan/meneliti AI itu sendiri, 30% memakai AI dalam riset mereka, 22% tidak memakainya sama sekali
  • Bahkan di antara peneliti yang mempelajari/mengembangkan AI itu sendiri, hanya 28% memakai generative AI (semacam ChatGPT) setiap hari/lebih dari sekali seminggu; pada peneliti yang sekadar memakai AI, hanya 13%
  • Optimisme jangka panjang jauh lebih tinggi dari pemakaian saat ini: 27% memperkirakan AI akan jadi “esensial” bagi bidang mereka dalam satu dekade, dibanding hanya 4% yang menyebutnya esensial sekarang

Untuk apa peneliti sebenarnya memakainya?

  • Urutan pemakaian dari yang paling umum: hiburan kreatif yang tidak terkait riset (justru paling sering), menulis kode, curah gagasan, menulis naskah, mengerjakan riset, tinjauan literatur, mesin pencari, urusan administratif
  • Artinya: pemakaian AI oleh peneliti jauh lebih beragam dan lebih “biasa” daripada citra “AI menulis paper untuk saya” yang sering dibayangkan
  • Pola serupa muncul pada survei terhadap sosiolog: pemakaian AI bersifat bimodal (kelompok pemakai rutin cukup besar, tapi kelompok “tidak pernah” juga besar), paling tinggi untuk menulis, paling rendah untuk pengumpulan data

Peneliti tetap khawatir

  • 69% khawatir AI mendorong ketergantungan pada pengenalan pola tanpa pemahaman
  • 68% khawatir AI mempermudah penyebaran misinformasi dan plagiarisme yang sulit dideteksi
  • 66% khawatir AI membawa kesalahan/ketidakakuratan masuk ke naskah publikasi
  • 58% khawatir AI melanggengkan bias yang ada di data latihnya

Khawatir sambil tetap memakai

Angka-angka ini datang dari peneliti yang sudah memakai AI. Sikap kritis tidak membuat mereka berhenti memakainya.

AI Fluency Framework 🧭

Sekadar familiar/bisa menggunakan tidak cukup

  • Literasi AI — tahu apa itu AI, cara kerjanya secara umum, istilah-istilahnya
  • Fluency AI — kemampuan bekerja efektif, efisien, etis, dan aman dalam berbagai bentuk interaksi manusia-AI
  • Fluency diukur dari seberapa baik Anda menilai apa yang dihasilkan AI dan bertanggung jawab atas cara Anda memakainya
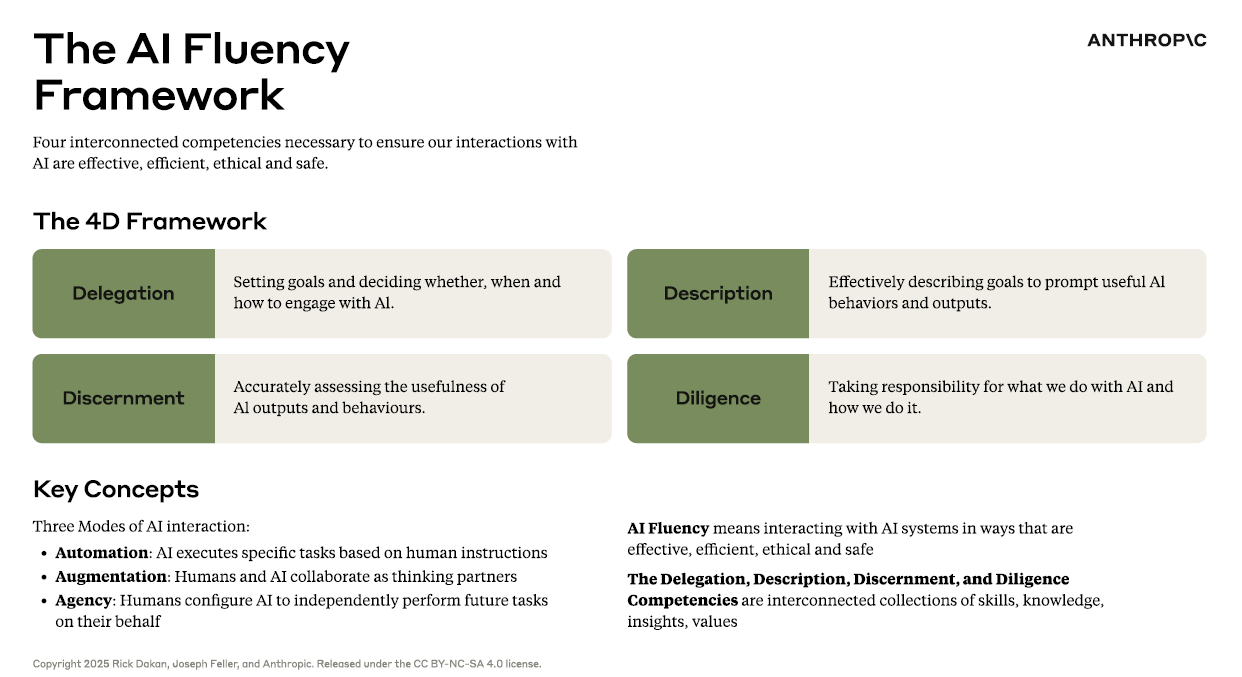
  • Kerangka yang akan kita pakai berasal dari kursus daring Anthropic, “AI Fluency: Framework & Foundations.”

Tiga mode interaksi manusia-AI

  • Automation — AI mengeksekusi tugas spesifik yang Anda definisikan.
    • Contoh prompt: “Terjemahkan abstrak ini ke bahasa Indonesia.”
  • Augmentation — Anda dan AI jadi mitra berpikir, bergantian mendefinisikan dan mengerjakan.
    • Contoh prompt: “Ayo kita bedah kelemahan desain penelitian saya satu per satu.”
  • Agency — Anda mengatur AI untuk bekerja mandiri atas nama Anda dalam jangka waktu tertentu.
    • Contoh prompt: “Setiap ada artikel baru tentang topik reproducibility, ringkas isinya dan kirimkan ke email saya setiap pagi.”

Sebelum masuk ke 4D

Keempat kompetensi berikutnya berlaku di ketiga mode ini, tetapi risiko dan kebutuhan pengawasannya berbeda jauh. Pada mode Agency, AI bekerja paling lama tanpa Anda awasi, jadi pemeriksaan Anda atas hasilnya harus paling ketat.

Kerangka 4️⃣D AI Fluency

Delegation dan Description menentukan seberapa efektif dan efisien kolaborasi Anda dengan AI. Discernment dan Diligence menentukan seberapa etis dan aman. Keempatnya saling terkait dan tidak harus dijalankan berurutan.

1️⃣ Delegation — memutuskan siapa mengerjakan apa

  • Memilah: bagian mana tetap Anda kerjakan sendiri, bagian mana dikerjakan bersama AI, bagian mana bisa diserahkan penuh
  • Butuh dua hal: paham tugas Anda sendiri (apa sebenarnya yang ingin Anda capai) dan paham kemampuan platform AI (apa yang realistis diharapkan darinya)
Tugas Delegasi
Merumuskan pertanyaan penelitian Anda (AI boleh jadi mitra diskusi)
Menyusun draf item/alat ukur awal AI, lalu Anda validasi dan seleksi secara ketat
Menerjemahkan instrumen penelitian AI, lalu Anda periksa kesepadanan makna secara manual
Menginterpretasi hasil analisis statistik Anda dan AI bersama: AI menawarkan alternatif interpretasi, keputusan akhir tetap di tangan Anda
Menyunting bahasa akademik di naskah AI, lalu Anda sunting ulang dan pastikan kontribusi Anda tetap signifikan

2️⃣ Description — AI tidak bisa membaca pikiran Anda

  • Kualitas output AI sebagian besar ditentukan oleh seberapa jelas Anda menjelaskan tiga hal: apa yang Anda inginkan (product), bagaimana prosesnya (process), dan bagaimana AI harus merespons selama interaksi (performance).
  • Enam teknik praktis: beri konteks, beri contoh output yang diinginkan, tentukan batasan (format, panjang), pecah tugas kompleks jadi bertahap, minta AI berpikir dulu sebelum menjawab, tentukan peran/persona atau tone output-nya.
  • Lihat contoh prompt engineering yang saya lakukan untuk menyusun feedback dengan persona sebagai dosen penguji tugas akhir.

Prompting adalah percakapan

Jangan berharap prompt pertama Anda sempurna. Perlakukan sebagai dialog yang terus disempurnakan berdasarkan respons yang Anda terima. Anda juga bisa minta AI membantu memperbaiki prompt Anda.

Contoh prompt engineering

Automation 😞

Buatkan tiga halaman tinjauan pustaka tentang depresi untuk tesis saya.

Augmentation 😊

Kamu adalah asisten riset yang kritis dan teliti. Saya mahasiswa S2 psikologi yang sedang menyusun proposal tesis tentang depresi pada mahasiswa magister.

Bantu saya menyusun kerangka/outline tinjauan pustaka: * Identifikasi 4-6 tema besar yang lazim dibahas dalam literatur depresi (misalnya: pengukuran, prediktor, intervensi). * Untuk tiap tema, tuliskan 2-3 pertanyaan yang perlu dijawab tinjauan pustaka saya. * Sarankan istilah/kata kunci pencarian (dalam bahasa Inggris) untuk tiap tema.

Perhatikan batasan ini: jangan mengarang referensi yang tidak pernah ada. Kalau tidak yakin, terbuka saja bilang tidak yakin. Kalau konteks dari saya berikan masih kurang detail, berikan pertanyaan sebelum mulai tugasnya. Jangan selalu setuju dengan argumen saya; berperanlah sebagai devil’s advocate.

3️⃣ Discernment — mengevaluasi output AI

  • Description mengatur apa yang Anda sampaikan ke AI; Discernment mengatur cara Anda menilai apa yang kembali dari AI
  • Tiga sisi yang perlu dinilai sekaligus:
    • Product discernment — apakah isinya akurat, relevan, koheren?
    • Process discernment — apakah alur penalarannya masuk akal, atau ada lompatan logika yang janggal?
    • Performance discernment — apakah AI merespons pertanyaan Anda secara spesifik, atau menjawab pertanyaan yang sifatnya generik?

Makin canggih model, makin perlu penilai manusia

Model yang lebih besar membuat kesalahan yang lebih meyakinkan, sehingga lebih sulit ditangkap oleh pembaca yang tidak menguasai topiknya.

🎯 Praktik: uji Discernment

Instruksi

Pilih satu konsep/konstruk inti dari topik tesis Anda. Minta AI memberikan tiga penjelasan berbeda untuk konsep tersebut, misalnya tiga cara menjelaskan konstruknya untuk audiens berbeda, atau tiga sudut pandang teoretis yang berbeda.

  • Nilai ketiganya dengan tiga kriteria: produk (mana yang paling akurat?), proses (mana yang penalarannya paling koheren?), performa (mana yang paling peka terhadap nuansa bidang Anda?)
  • Tandai secara spesifik: bagian mana yang membuat Anda percaya, bagian mana yang membuat Anda curiga, dan kenapa.

Pertanyaan refleksi

Pengetahuan spesifik apa yang membuat Anda bisa menangkap kelemahan tadi? Bagaimana mahasiswa dari bidang lain akan menilai output yang sama persis?

4️⃣ Diligence — bertanggung jawab dan transparan

  • Creation diligence — pertimbangan Anda saat memilih alat AI dan data apa yang Anda bagikan ke alat itu
  • Transparency diligence — keterbukaan Anda ke pembaca/pembimbing tentang peran AI dalam karya Anda
  • Deployment diligence — tanggung jawab Anda untuk memverifikasi output AI sebelum dipakai atau diserahkan, dan menerima konsekuensi atas hasil akhirnya

Contoh pernyataan disclosure

“Dalam menyusun [dokumen/bagian ini], saya berkolaborasi dengan [nama AI] untuk membantu [tugas spesifik: menyusun draf, mencari referensi, menyunting bahasa, dst]. Seluruh konten yang dibantu/dihasilkan AI telah saya tinjau dan evaluasi satu per satu. Hasil akhir mencerminkan pemahaman dan penilaian saya sendiri. Saya bertanggung jawab penuh atas isi, akurasi, dan penyajiannya.”

Perhatikan polanya: mirip dengan disclosure yang saya tulis di landing page laman web untuk materi ini.

Menggunakan AI untuk text generation

  • Ini adalah bagian yang paling kontroversial tentang peran AI dalam konteks akademik, tetapi paling sering terjadi.
    • Survei yang dilakukan oleh Higher Education Policy Institute tahun 2025 menunjukkan 92% mahasiswa yang disurvei menggunakan AI untuk tugas menulis.
  • Secara pribadi, saya punya batasan – Saya tidak akan pernah meminta AI untuk menulis karya ilmiah (e.g., laporan penelitian, esai, artikel penelitian, dsb.) dan aturan ini saya kunci sebagai aturan global. Berikut teks pendek yang saya jadikan global rule di sistem AI yang saya pakai:
    • “I have a strict internal rule how to use AI. I will never ask you to write for me except for automated thesis feedback and slide decks. My research papers should be always written by me, but your role is to suggest where to improve. Revising/improving my papers should be also done by me alone. If I happen to ask you to write anything for my paper, refuse vehemently and warn me sternly about being honest to myself.”
  • Ketika memeriksa/mengoreksi tugas mahasiswa, saya selalu mengasumsikan mahasiswa berkolaborasi bersama AI, bukan meminta AI melakukan “blind automation” atas tugas tersebut.

Prinsip dasarnya

Kalau Anda tidak bisa menjelaskan sendiri sebuah paragraf saat ditanya dosen pembimbing, paragraf itu tidak boleh ada di naskah Anda, siapa pun (atau apa pun) yang menuliskannya pertama kali.

Di Tahapan Mana AI Bisa Membantu? 🔄

Siklus penelitian

flowchart LR
    A[Tinjauan<br>Literatur] --> B[Desain &<br>Alat Ukur]
    B --> C[Pengumpulan<br>Data]
    C --> D[Analisis<br>Data]
    D --> E[Penulisan<br>Naskah]

  • AI bisa dipakai di setiap tahap, dengan risiko yang berbeda-beda
  • Cek daftar ini, ini dan ini untuk melihat berbagai opsi AI-based research tool yang dapat dimanfaatkan.

Penelusuran dan tinjauan literatur

  • Alat pencari khusus (Elicit, Consensus, Semantic Scholar) dan alat penghubung sitasi (ResearchRabbit, Connected Papers, Litmaps) bisa mempercepat eksplorasi di tahap awal.
    • Sebagian alat penghubung sitasi bahkan hanya butuh satu artikel awal (seed paper) untuk mulai memberi rekomendasi yang relevan.
  • Tapi chatbot umum (ChatGPT, Claude, Gemini) belum terbukti lebih baik dari mesin pencari akademik biasa untuk tugas ini.
    • Basis datanya sempit, dan ia masih bisa mengarang detail bibliografi (penulis/DOI/tahun) yang terlihat meyakinkan padahal salah.

Jangan salin sitasi AI

Cek setiap rujukan dari AI ke sumber aslinya (DOI, situs penerbit) sebelum masuk daftar pustaka, dan baca artikelnya sendiri, bukan hanya ringkasan dari AI.

Desain penelitian dan penyusunan alat ukur

  • AI bisa membantu curah gagasan desain, menyusun draf item skala, bahkan menghasilkan hipotesis validitas konvergen/diskriminan secara sistematis
  • Contoh: alat Psychometric Item Generator menghasilkan ratusan calon item hanya dari 3–6 contoh kalimat. Versi skala Big Five 20-item hasil AI berkorelasi r = .73–.82 dengan skala baku 60-item, dengan reliabilitas tes-ulang yang sebanding.
  • Tapi tetap ada batasnya: dalam satu studi, sekitar 25% saran skala kriteria dari ChatGPT untuk validasi konstruk ternyata bermasalah, sebagian bahkan skala yang tidak pernah ada
Hommel & Arslan (2025): LLM bisa menyimpulkan korelasi antar-item/skala psikologis langsung dari teksnya.

Prinsipnya

AI cocok untuk menghasilkan kumpulan awal kandidat item/hipotesis yang harus disaring ketat oleh Anda dan pembimbing lewat validasi psikometrik.

Contoh lain: AI untuk penilaian konstruk psikologis
  • Model bahasa bisa menyimpulkan skor kepribadian dari teks jawaban terbuka (zero-shot scoring), tanpa data pelatihan khusus untuk peserta itu
  • Model bahasa juga bisa dipakai untuk menghasilkan dan memvalidasi jaringan item baru secara otomatis
  • AI mempercepat langkah-langkah tertentu di dalam proses psikometri; validasi konvensional tetap wajib sebelum skala itu dipakai

Pengumpulan data: tahap paling sensitif

  • Pemakaian AI paling rendah di tahap ini. Wajar, karena di sinilah Anda berurusan langsung dengan data partisipan
  • Beberapa pemakaian yang mulai berkembang: transkripsi wawancara otomatis, penerjemahan instrumen, dan simulasi respons manusia terhadap item survei (“silicon sampling”) untuk melengkapi data manusia yang sulit dijangkau
  • Silicon sampling masih sangat diperdebatkan: responsnya dikondisikan dari profil demografis, bukan dari pengalaman hidup seseorang yang sebenarnya

Batas yang tidak boleh dilanggar

Jangan pernah mengunggah data mentah partisipan (apalagi yang belum dianonimkan) ke chatbot publik. Lebih detail soal ini di bagian Risiko.

Analisis data penelitian

  • Untuk analisis kualitatif, AI bisa berperan sebagai pengode kedua atau “devil’s advocate” yang menantang sistem pengodean yang Anda kembangkan secara manual.
  • Protokol yang umum dipakai: manusia dan AI mengode data secara paralel, perbedaan hasil dibandingkan dan didiskusikan, lalu reliabilitas antar-pengode (mis. Cohen’s Kappa) tetap dihitung seperti biasa
  • Untuk analisis kuantitatif, AI bisa membantu menulis atau memperbaiki kode statistik (R, Python), tapi kodenya tetap perlu Anda uji dan pahami logikanya

Penting untuk diingat

Apa pun tugas pengodean yang dibantu AI, laporkan model/versinya secara eksplisit dan validasi hasilnya terhadap pengodean manusia dengan ukuran reliabilitas standar.

Penulisan naskah

  • Dua pertiga pemakaian AI untuk menulis berupa penyuntingan teks yang sudah ada (memperbaiki tata bahasa, memparafrase, menerjemahkan, meringkas)
  • AI juga mulai dipakai untuk memberi umpan balik naskah sebelum dikirim ke pembimbing atau jurnal: berguna sebagai “pembaca pertama”, tapi tidak bisa menggantikan telaah sejawat
  • Bagian yang ditulis AI dari nol paling berisiko: pastikan argumen dan penalarannya tetap milik Anda

Ringkasan: delegasi di sepanjang siklus penelitian

Tahap Peran AI yang disarankan Yang tetap harus Anda lakukan sendiri
Tinjauan literatur Eksplorasi awal, ringkasan kasar Verifikasi tiap sitasi, sintesis argumen
Desain & alat ukur Draf item/hipotesis awal Seleksi, validasi psikometrik
Pengumpulan data Transkripsi, terjemahan instrumen Kontak dengan partisipan, keputusan etik
Analisis data Pengode kedua, draf kode statistik Interpretasi akhir, keputusan analitik
Penulisan naskah Penyuntingan bahasa, umpan balik draf Argumen inti, klaim ilmiah, tanggung jawab isi

Risiko dan Mitigasinya ⚠️

Halusinasi dan kutipan yang tidak pernah ada

Risiko

  • AI bisa mengarang detail referensi (penulis, tahun, DOI) yang terlihat sangat meyakinkan.
  • Dalam satu pengujian, sekitar seperempat saran skala kriteria validasi yang dihasilkan AI ternyata bermasalah atau tidak benar-benar ada.

Mitigasi

  • Selalu telusuri dan baca sumber aslinya; jangan salin sitasi AI langsung ke naskah.
  • Perlakukan setiap klaim faktual dari AI sebagai hipotesis yang perlu diverifikasi.

Privasi dan kerahasiaan data

Risiko

  • Data yang Anda unggah ke chatbot publik (termasuk data partisipan, naskah belum terbit) berpotensi dipakai sebagai data latihan lanjutan oleh penyedia layanan.
  • Sebagian penerbit jurnal membuat kesepakatan lisensi dengan penyedia AI atas teks artikel, tanpa opsi bagi penulis untuk tidak ikut serta.

Mitigasi

  • Anonimkan data partisipan sebelum diproses AI dalam bentuk apa pun, dan hanya proses data yang sudah disetujui secara etik untuk itu.
  • Periksa kebijakan privasi/penyimpanan data platform sebelum mengunggah apa pun yang sensitif.

Hak cipta dan orisinalitas

Risiko

  • Sebagian alat AI bisa mereproduksi karya berhak cipta hampir kata demi kata.
  • Parafrase yang dihasilkan AI dari sumber tertentu, jika tidak ditandai, bisa dianggap plagiarisme tanpa Anda sadari.

Mitigasi

  • Baca sendiri teks sumber aslinya; ringkasan AI tidak menggantikan membaca.
  • Ikuti kebijakan program studi/jurnal tentang disclosure pemakaian AI, dan tandai bagian mana yang dibantu AI.

Bias dalam LLM

Risiko

  • LLM dilatih dari data yang secara geografis dan sosial timpang, sehingga cenderung paling akurat merepresentasikan populasi Barat yang berbahasa Inggris.
  • Untuk riset psikologi lintas budaya, ini berarti output AI bisa mencerminkan asumsi budaya tertentu.

Mitigasi

  • Jangan asumsikan output AI netral pada perbedaan budaya, terutama saat topik Anda melibatkan populasi non-Barat atau konstruk yang sensitif budaya.
  • Bandingkan output AI dengan literatur lokal/kontekstual sebagai pengecekan silang.

Ketergantungan berlebihan dan “atrofi” kemampuan metodologis

Risiko

  • Cognitive offloading — menyerahkan proses berpikir ke alat eksternal bisa melemahkan kemampuan itu sendiri seiring waktu, terutama bagi yang belum mahir di bidangnya
  • “Point-and-click scholarship” — menghasilkan atau menafsirkan hasil statistik tanpa benar-benar memahami logikanya, karena jawaban AI terdengar yakin

Mitigasi

  • Pakai AI untuk mempercepat tahap yang sudah Anda kuasai, jangan untuk melewati tahap belajar yang sedang Anda perlukan.
  • Terapkan loop Description–Discernment secara terus-menerus: jangan terima output pertama begitu saja.

Reliabilitas dan reproducibility

  • Output AI bersifat probabilistik: prompt yang identik bisa menghasilkan jawaban berbeda di waktu berbeda, sehingga sulit direplikasi.
  • Untuk tugas pengodean/analisis, perubahan kecil pada konfigurasi model (versi, temperature, bahkan susunan kalimat prompt) bisa mengubah kesimpulan analitik secara substansial.

Praktik minimum untuk riset yang bisa direplikasi

Laporkan nama dan versi model persis yang Anda pakai (jangan cuma tulis “AI”), tetapkan dan laporkan nilai temperature (rendah untuk tugas yang butuh konsistensi), dan validasi hasil AI terhadap pengodean/penilaian manusia sebelum dipakai sebagai temuan.

Kesimpulan 🎓

  • Sebelum menyerahkan apa pun yang dibantu AI (ke pembimbing, ke naskah, ke data), tanyakan tiga hal:
    • Sudahkah saya verifikasi faktanya?
    • Sudahkah saya pastikan tidak ada data pribadi partisipan yang saya berikan ke AI?
    • Sudahkah saya jujur soal peran AI di sini?
  • Tanggung jawab atas output AI tetap di tangan Anda, dan kemampuan mengevaluasinya tumbuh dari domain expertise yang sedang Anda bangun dengan menempuh pendidikan magister.
  • Kalau Anda tidak bisa menjelaskan sendiri sebuah paragraf saat ditanya dosen pembimbing, paragraf itu tidak boleh ada di naskah Anda, siapa pun (atau apa pun) yang menuliskannya pertama kali.
  • Pertanyaan refleksi setelah workshop ini: putuskan di tahap mana dari tesis Anda, AI paling mungkin membuat Anda melewatkan proses belajar yang sebenarnya Anda perlukan?

🏠 Setelah workshop ini

Dalam seminggu ke depan, susun strategi/kebijakan pribadi Anda dalam menggunakan AI selama mengerjakan tugas akhir. Dalam menyusun strategi ini, Anda bisa menggunakan AI sebagai mitra diskusi Anda.

Renungkan 4️⃣ poin di bawah:

  1. Kapan (dan untuk apa) saya akan, dan tidak akan, menggunakan AI?
  2. Batasan apa yang saya tetapkan untuk data dan informasi sensitif?
  3. Bagaimana saya memverifikasi karya yang dibantu AI sebelum diserahkan ke dosen?
  4. Bagaimana saya mengungkapkan penggunaan AI kepada dosen pembimbing?

Rujukan

  • Alvero, A., Stoltz, D., Stuhler, O., & Taylor, M. (2026). Generative AI in sociological research: State of the discipline. Sociological Science, 13, 45–62.
  • Austin, K. D., Crawley, H. K., Fleeson, W., & Furr, R. M. (2025). Using generative artificial intelligence to advance hypothesis-driven scale validation: Identifying criterion measures and generating precise a priori hypotheses. Assessment. Advance online publication. https://doi.org/10.1177/10731911251401321
  • Baumgarten, L., Lahrsow, M., & Kalmbach, F. (2025). AI research tool overview [Overview table]. Tübingen University Library.
  • Bent, D., Dakan, R., Feller, J., & Vo, M. (2026). AI fluency: Framework & foundations [Kursus daring]. Anthropic. https://anthropic.skilljar.com/ai-fluency-framework-foundations
  • Bolaños, F., Salatino, A., Osborne, F., & Motta, E. (2024). Artificial intelligence for literature reviews: Opportunities and challenges. Artificial Intelligence Review, 57(10), 259. https://doi.org/10.1007/s10462-024-10902-3
  • Cash, T. N., Kelly, M. O., Macnamara, B. N., & Risko, E. F. (2026). Is AI making us stupid? Trends in Cognitive Sciences. https://www.sciencedirect.com/science/article/pii/S1364661326001312
  • Chatterji, A., Cunningham, T., Deming, D., Hitzig, Z., Ong, C., Shan, C., & Wadman, K. (2025). How people use ChatGPT [Working paper]. OpenAI/NBER.
  • Costa, A. P., Bryda, G., Christou, P. A., & Kasperiuniene, J. (2025). AI as a co-researcher in the qualitative research workflow: Transforming human-AI collaboration. International Journal of Qualitative Methods, 24, 1–12. https://doi.org/10.1177/16094069251383739
  • Dakan, R., & Feller, J. (2025). Framework for AI fluency: Practical overview document (Version 1.1). Ringling College of Art and Design; University College Cork. https://ringling.libguides.com/ai/framework
  • Fung, P., Bachrach, Y., Celikyilmaz, A., et al. (2025). Embodied AI agents: Modeling the world. arXiv. https://arxiv.org/abs/2506.22355
  • Ghali, M.-K., Farrag, A., Sakai, H., El Baz, H., Jin, Y., & Lam, S. (2024). GAMedX: Generative AI-based medical entity data extractor using large language models. arXiv. https://arxiv.org/abs/2405.20585
  • Götz, F. M., Maertens, R., Loomba, S., & van der Linden, S. (2024). Let the algorithm speak: How to use neural networks for automatic item generation in psychological scale development. Psychological Methods, 29(3), 494–518. https://doi.org/10.1037/met0000540
  • Higgins, W. C., Clarke, B., Elson, M., & Cummins, J. (2026). Recommendations for incorporating LLMs into psychological research: A commentary on Austin and colleagues (2026) [Preprint].
  • Hommel, B. E., & Arslan, R. C. (2025). Language models accurately infer correlations between psychological items and scales from text alone. Advances in Methods and Practices in Psychological Science. https://doi.org/10.1177/25152459251377093
  • Lahrsow, M., & Baumgarten, L. (2026). Literature search with AI: Tips and tools [Workshop slides]. Tübingen University Library.
  • Potts, C., & Sudhof, M. (2026). A paradox of AI fluency [Technical report]. Bigspin AI.
  • Risko, E. F., & Gilbert, S. J. (2016). Cognitive offloading. Trends in Cognitive Sciences, 20(9), 676–688.
  • Rogers, T., & Carbonaro, M. (2025). From understanding to creating: Bridging AI literacy and AI fluency in K-12 education. Journal of Teaching and Learning, 19(4), 20–38.
  • Russell-Lasalandra, L. L., Christensen, A. P., & Golino, H. (2024). Generative psychometrics via AI-GENIE: Automatic item generation and validation with network-integrated evaluation. PsyArXiv. https://doi.org/10.31234/osf.io/fgbj4
  • Shao, Y., Zope, H., Jiang, Y., Pei, J., Nguyen, D., Brynjolfsson, E., & Yang, D. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv. https://arxiv.org/abs/2506.06576
  • Storey, V. C. (2026). AI tools boost scientists’ impact but narrow focus. Nature, 649, 1111–1112.
  • Van Noorden, R., & Perkel, J. M. (2023). AI and science: What 1,600 researchers think. Nature, 621, 672–675. https://doi.org/10.1038/d41586-023-02980-0
  • Van Quaquebeke, N., Tonidandel, S., & Banks, G. C. (2025). Beyond efficiency: How artificial intelligence (AI) will reshape scientific inquiry and the publication process. The Leadership Quarterly, 36, 101895. https://doi.org/10.1016/j.leaqua.2025.101895
  • Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998–6008.
  • Wright, A. G. C., Ringwald, W. R., Vize, C. E., Eichstaedt, J. C., Angstadt, M., Taxali, A., & Sripada, C. (2026). Assessing personality using zero-shot generative AI scoring of brief open-ended text. Nature Human Behaviour.
  • Yang, J., Yonack, N., Zyskowski, K., Yarats, D., Ho, J., & Ma, J. (2025). The adoption and usage of AI agents: Early evidence from Perplexity [Working paper].

Terima kasih!😊

Ada pertanyaan?

Paparan disusun dengan menggunakan dan Quarto dengan template dari UNAIR Theme.