Menyajikan Data
Literasi Data dan Penulisan Ilmiah
2026-09-25
Agenda
- Presenting vs. visualizing
- Memilih jenis data dan bentuk visualisasi yang tepat
- Enam prinsip storytelling with data (Knaflic, 2015)
- Studi kasus: memvisualisasikan dataset Big Five
- Beberapa pilihan alat bantu: spreadsheet, Tableau/Datawrapper, Canva
Presenting vs. Visualizing Data 🎨
Point of entry
“Apa yang saya harapkan audiens saya lakukan/pahami dari data yang saya miliki ini?”
- Parameter kunci penyajian data adalah audiens dan pesan (Open Knowledge Foundation (2021)).
- Mungkinkah strategi visualisasi data (e.g., menggunakan plot, grafik) dapat dilakukan ketika:
- Anda menyajikan temuan riset Anda melalui siaran radio?
- Temuan disajikan pada audiens dengan gangguan penglihatan?
- Menyajikan hasil analisis data di komunitas yang tidak familiar dengan grafik sama sekali?
- Dalam semua kasus di atas, grafik/visualisasi saja tidak cukup.
- Itulah mengapa pertemuan ini menekankan pada “Menyajikan Data”, bukan “Memvisualisasikan Data”
- …karena visualisasi hanyalah salah satu alat komunikasi data, tetapi bukan tujuan akhirnya.
Data visualization vs. infografis
Perbedaannya menurut Open Knowledge Foundation (2021):
Data visualization
- Terkait langsung dengan data yang mendasarinya.
- Bisa interaktif dan bereaksi terhadap perubahan data.
- Jumlah format yang valid terbatas, tetapi harus tetap merepresentasikan data secara transparan.
- Lihat katalognya di sini (DataViz Catalogue).
Infografis
- “Grafik + informasi” — menyajikan suatu “cerita” berbasis data secara visual.
- Sering memuat visualisasi data, tapi tidak selalu langsung terkait dengan data mentahnya.
- Lebih leluasa secara desain, tapi penggunaannya lebih terbatas pada komunikasi pada audiens umum (bukan audiens yang spesifik/ahli).
- Dapat menjadi produk Jurnalistik Data.
Tiga elemen yang bisa ditonjolkan
Open Knowledge Foundation (2021) membedakan tiga elemen yang bisa Anda tonjolkan saat menyajikan data:
- Data — visualisasi sederhana yang membantu audiens cepat menangkap informasi kunci; interaktivitas (apabila memungkinkan) membuat eksplorasi lebih menyenangkan di sisi audiens.
- Desain — butuh kepekaan desain, tapi bisa menghasilkan visual yang sangat menarik dan mudah diingat meski format visualnya kurang familier bagi audiens.
- Pesan — menempatkan storytelling sebagai yang utama; data dan desain melayani narasi yang ingin disampaikan.
Beberapa contoh yang menarik:
- Google AI journey
- Risiko automasi pada beberapa jenis pekerjaan
- El Niño Observatory
Memilih Jenis Data dan Jenis Visualisasi 📊
Kategorikal vs. continuum
Ingat Pertemuan 1: perbedaan data kategorikal dan numerik sekarang menentukan pilihan grafik Anda.
- Data kategorikal (mis. gender, kelompok skor) — cocok untuk bar chart, pie chart. Tapi grafik butuh minimal satu nilai continuum untuk dipasangkan, walaupun itu hanya hasil hitungan dari kategorinya (mis. frekuensi atau rata-rata skor per kategori) — dua variabel kategorikal tidak bisa langsung digambar tanpa menghitung sesuatu dari keduanya (Open Knowledge Foundation, 2021).
- Data continuum (mis. usia, skor skala) — bisa dipasangkan di kedua sumbu, seperti pada scatterplot atau histogram.
- Data continuum bisa ditampilkan sebagai kategorikal (usia dikelompokkan jadi rentang), tapi tidak berlaku sebaliknya.
- Anda bisa memanfaatkan ChartChooser untuk menentukan grafik apa yang sesuai dengan tujuan dan jenis data Anda.
“Saya ingin menunjukkan…”
Cara termudah memilih visualisasi: lengkapi kalimat “Saya ingin menunjukkan…” (Open Knowledge Foundation, 2021)
| Saya ingin menunjukkan… | Jenis visualisasi |
|---|---|
| Jumlah partisipan pada tiap kategori usia | Perbandingan (comparison) |
| Proporsi partisipan yang skor Extraversion-nya tinggi vs rendah | Perbandingan, bagian-dari-keseluruhan |
| Perubahan rata-rata skor kesejahteraan dari minggu ke minggu | Perbandingan, pola, data dari waktu ke waktu |
| Sebaran skor Conscientiousness di seluruh sampel | Distribusi |
Ragam tujuan visualisasi dan grafiknya
Diadaptasi dari Open Knowledge Foundation, 2021:
- Perbandingan → bar chart
- Bagian-dari-keseluruhan → pie chart, stacked bar chart (catatan: Knaflic, 2015, menyarankan menghindari pie chart karena mata kita sulit membandingkan luas irisan; bar chart biasanya lebih mudah dibaca)
- Distribusi → histogram, box plot
- Hubungan (antara dua variabel continuum) → scatterplot
- Data dari waktu ke waktu → line chart
- Lokasi → peta
Tidak ada daftar jenis visualisasi data yang lengkap. Satu grafik bisa saja memenuhi lebih dari satu tujuan sekaligus. Yang penting: rumuskan tujuannya dulu, baru pilih grafiknya.
6️⃣ Prinsip Storytelling with Data 📖
Kerangka dari Cole Nussbaumer Knaflic
Buku Storytelling with Data (Knaflic, 2015) merangkum enam prinsip inti untuk penyajian data yang efektif:
- Pahami konteksnya
- Pilih visual yang tepat
- Minimalisasi informasi yang kurang relevan (cluttering)
- Arahkan perhatian audiens
- Berpikir seperti desainer
- Ceritakan sebuah kisah yang menarik
1️⃣ Pahami konteksnya
- Siapa audiens Anda? Apa yang sudah mereka tahu? Tindakan/pemahaman apa yang Anda ingin mereka dapatkan?
- Ini kelanjutan langsung dari pembahasan “tiga jenis audiens” di Pertemuan 6.
2️⃣ Pilih visual yang tepat
Sudah kita bahas di bagian sebelumnya: cocokkan jenis data dan jenis visualisasi dengan bentuk grafik yang tepat. Jangan biarkan perangkat lunak “menebak” kemauan Anda, karena ia tidak tahu audiens dan konteks proyek Anda.
3️⃣ Minimalisasi informasi yang kurang relevan (cluttering)
- Clutter = elemen visual yang tidak menambah informasi, tapi membebani mata audiens: gridlines tebal, efek 3D, terlalu banyak warna, border berlebihan.
- Aturan praktis: kalau menghapus sebuah elemen tidak mengurangi informasi yang tersampaikan, hapus saja.
4️⃣ Arahkan perhatian audiens
- Mata manusia tertarik secara otomatis pada elemen tertentu (warna kontras, ukuran lebih besar, posisi) — inilah yang disebut preattentive attributes.
- Gunakan ini secara sengaja: beri warna berbeda pada satu batang yang ingin Anda tonjolkan, sementara batang lain tetap abu-abu netral.
- Saat memakai warna, ingat audiens dengan buta warna: hindari memasangkan merah dan hijau sebagai satu-satunya pembeda.
5️⃣ Berpikir seperti desainer
- Desain yang baik bukan cuma soal estetika, tetapi soal fungsi: apakah audiens tahu ke mana harus melihat lebih dulu? Apakah visualisasinya mudah diakses, dalam arti tidak terlalu rumit bagi audiens dengan tingkat keahlian teknis yang berbeda-beda?
- Prinsip ini menjembatani ke elemen “desain” yang kita bahas di awal pertemuan.
6️⃣ Ceritakan sebuah kisah yang menarik
Data tanpa narasi hanyalah angka-angka yang tidak bisa langsung dipahami maknanya. Visualisasi yang baik punya alur: situasi awal, ketegangan/temuan yang mengejutkan, dan resolusi/implikasi, persis seperti cerita yang baik pada umumnya.
Ini menyambung ke apa yang sudah kita bahas di Pertemuan 6 tentang hedging language. Hedging membantu untuk menjaga transparansi narasi, meskipun narasi itu juga perlu menarik agar mudah diingat.
Studi Kasus: Memvisualisasikan Dataset Big Five 🧬
Menentukan jenis visualisasi
Kita hitung skor Extraversion (setelah item reverse-scored dibalik, seperti prosedur Pertemuan 4-5) dari 19.511 partisipan dalam dataset kita (setelah pembersihan; data mentahnya 19.719 baris), dipilah berdasarkan gender.
“Saya ingin menunjukkan” perbandingan rata-rata skor Extraversion antara dua kategori gender → tugasnya adalah perbandingan → kandidat grafik: bar chart sederhana, dua batang.
Kedua grafik pada slide berikutnya dibuat dengan package ggplot2 langsung dari data/data.csv. Skripnya ada di slides/libs/make_pertemuan7_charts.R kalau Anda ingin melihat/menjalankannya sendiri.
Sebelum: melanggar hampir semua prinsip Storytelling
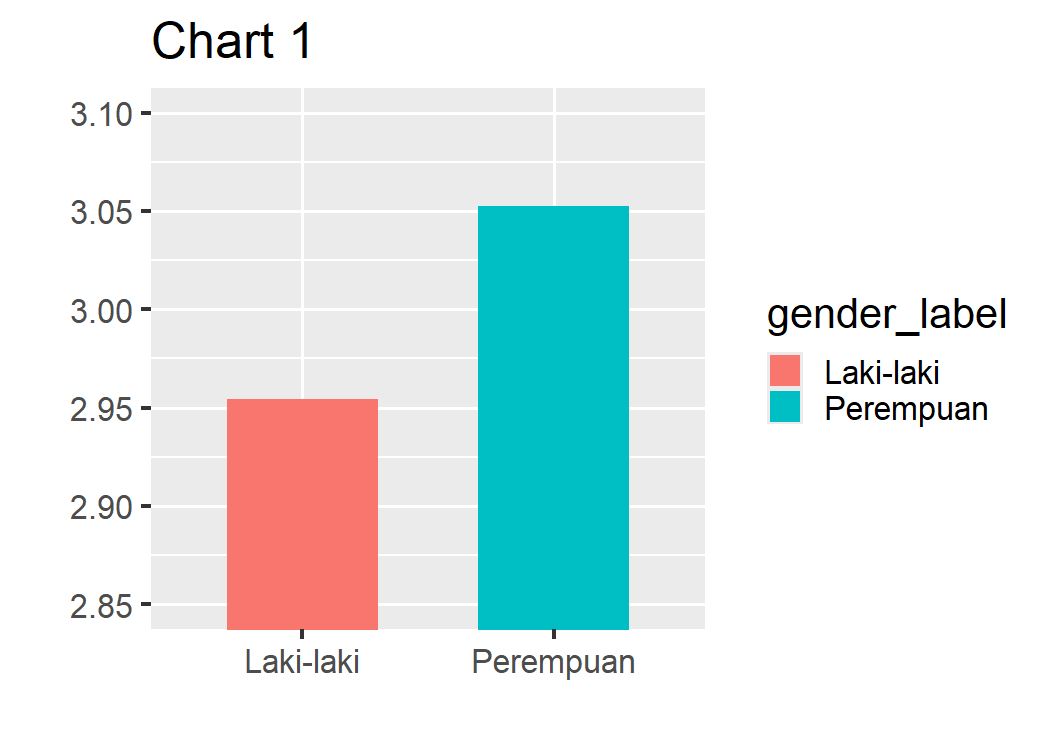
- Judul generik (“Chart 1”), tidak ada takeaway.
- Gridlines penuh dan legenda yang sebenarnya tidak perlu (label sumbu-x sudah cukup).
- Sumbu-y dipotong mulai dari 2.85, bukan dari 0. Akibatnya, secara visual ini membuat perbedaan kecil menjadi terlihat dramatis.
Sumbu-y yang dipotong adalah salah satu cara paling umum (dan paling menyesatkan) untuk membuat perbedaan kecil seolah-olah terlihat besar.
Sesudah: 6️⃣ prinsip diterapkan
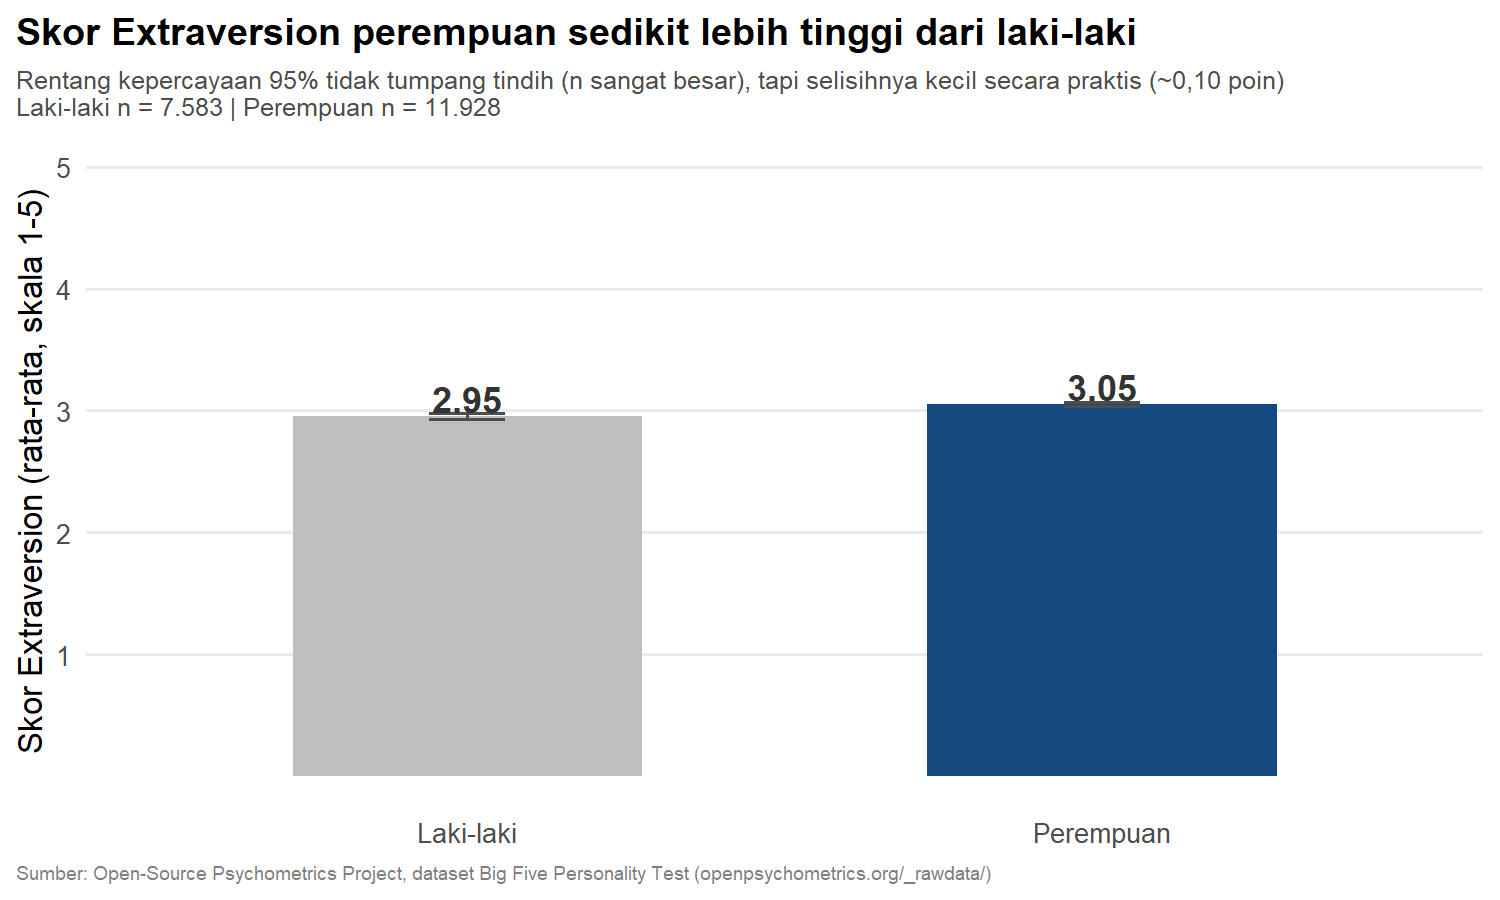
- Judul langsung menyampaikan takeaway (prinsip 6).
- Gridlines dan legenda dihapus (prinsip 3); satu warna aksen menonjolkan kelompok yang ingin difokuskan (prinsip 4).
- Sumbu-y dimulai dari 0 (label 1–5 menunjukkan rentang skala Likert aslinya), sehingga perbedaannya terlihat apa adanya.
- Interval kepercayaan 95% disertakan (prinsip Pertemuan 6), tetapi nyaris tak terlihat di grafik ini karena
nyang sangat besar membuatnya sangat sempit.
Signifikan secara statistik ≠ besar secara praktis
Dengan n sebesar ini, CI kedua kelompok tidak tumpang tindih, sehingga secara statistik perbedaannya signifikan, meskipun perbedaannya hanya ~0.10 poin pada skala 1–5.
Angka di balik grafiknya
Grafik tadi bagus untuk audiens umum, tapi naskah akademik (Pertemuan 6, APA style) tetap butuh tabel angka lengkap:
| Gender | n | M | SD | 95% CI |
|---|---|---|---|---|
| Laki-laki | 7,583 | 2.95 | 0.92 | [2.93, 2.97] |
| Perempuan | 11,928 | 3.05 | 0.92 | [3.04, 3.07] |
Perhatikan tabel ini mengikuti prinsip yang sama dari Pertemuan 2: judul kolom jelas, satuan tersirat dari konteks (skala 1–5), dan sumber datanya (data/data.csv, dataset Big Five) sudah disebutkan pada slide sebelumnya.
🧩 Aktivitas mandiri
Perhatikan grafik berikut ini. Terapkan enam prinsip storytelling with data untuk mengkritiknya:
- Menurut Anda, apa konteks/audiens yang dituju grafik ini? Apakah pilihan visualnya cocok?
- Identifikasi elemen yang termasuk clutter. Apa elemen yang bisa dihapus tanpa mengurangi informasi?
- Apakah perhatian audiens diarahkan dengan jelas ke bagian terpenting? Bagaimana caranya (atau kenapa tidak)?
- Apakah ada “kalimat kunci” atau takeaway yang bisa langsung dipahami tanpa membaca teks lain?
Alat Bantu Visualisasi 🛠️
Memilih alat sesuai audiens dan tujuan
- Fitur grafik di software spreadsheet standar (Google Sheets/Excel) — cukup untuk sebagian besar kebutuhan laporan, tugas kuliah dan naskah akademik; mendukung sebagian besar jenis grafik dasar.
- Tableau, Datawrapper, Infogram, MS Power BI — untuk visualisasi interaktif, cocok kalau audiens Anda perlu mengeksplorasi data sendiri (mis. membuat dashboard).
- Untuk Power BI, tanyakan ke DSI/USI apakah lisensinya termasuk di akun Microsoft Unair.
- Canva — untuk infografis, saat pesan dan desain lebih diutamakan; ini bisa jadi alat utama Anda untuk infografis UAS.
Kembali ke pembahasan “tiga jenis audiens” (Pertemuan 6): untuk komunitas akademik serumpun → grafik spreadsheet dalam naskah sudah cukup. Untuk publik awam → pertimbangkan infografis Canva. Jadi, alat bantu mengikuti audiens, bukan sebaliknya.
Penutup
Kesimpulan Pertemuan 7
- Mulai dari audiens dan pesan, baru pilih visualisasinya.
- Rumuskan tugas visualisasi dengan kalimat “saya ingin menunjukkan…”, lalu cocokkan dengan jenis data (kategorikal/continuum).
- Enam prinsip storytelling with data: pahami konteks, pilih visual tepat, singkirkan informasi yang kurang relevan, arahkan perhatian, berpikir seperti desainer, ceritakan kisah.
- Pilihan alat (spreadsheet, Tableau/Datawrapper, Canva) mengikuti audiens dan tujuan penyajian.
Referensi
- Knaflic, C. N. (2015). Storytelling with data: A data visualization guide for business professionals. Wiley.
- Open Knowledge Foundation. (2021). Data literacy curriculum. International Republican Institute.
Terima kasih!😊
Ada pertanyaan?
- amelia.zein@psikologi.unair.ac.id
- https://rameliaz.github.io/
- @rameliaz
- @rameliaz
- @rameliaz
Paparan disusun dengan menggunakan dan Quarto dengan template dari UNAIR Theme.